Il problema non è più capire se Google usa un LLM per sintetizzare pagine web. Il problema tecnico è ricostruire quali sistemi individuano i documenti candidati, quali passaggi vengono considerati affidabili, come vengono assemblate le affermazioni e in quale punto un contenuto acquisisce una citazione visibile. La differenza non è lessicale: cambia il modo in cui progettiamo una strategia SEO e il modo in cui la misuriamo.
Il brevetto US11769017B1, diventato popolare per l’elenco di ranking, selezione dei risultati, trustworthiness e freshness, rimane una fonte utile. Ma nel 2026 fermarsi a quel documento significa osservare solo un pezzo della catena. Ho riletto il brevetto originale insieme a pubblicazioni e famiglie successive — con una distinzione deliberata tra rivendicazioni del brevetto, architetture plausibili e funzionalità di Google Search realmente documentate. [1–7]
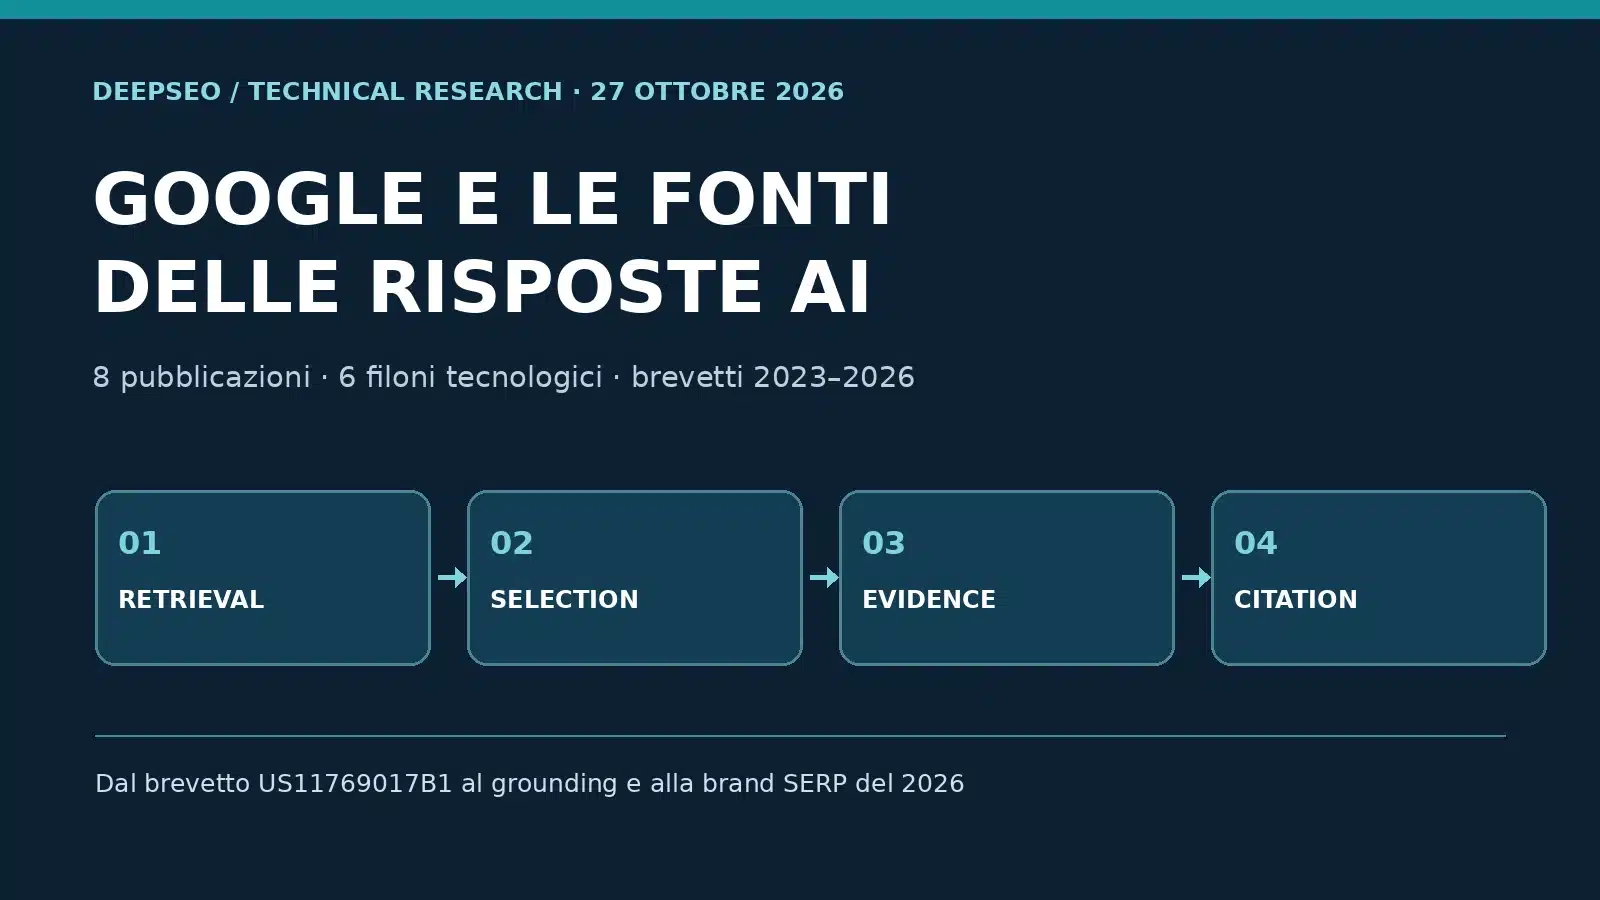
La distinzione che manca in molti post SEO: documento recuperato, fonte usata, citazione visibile
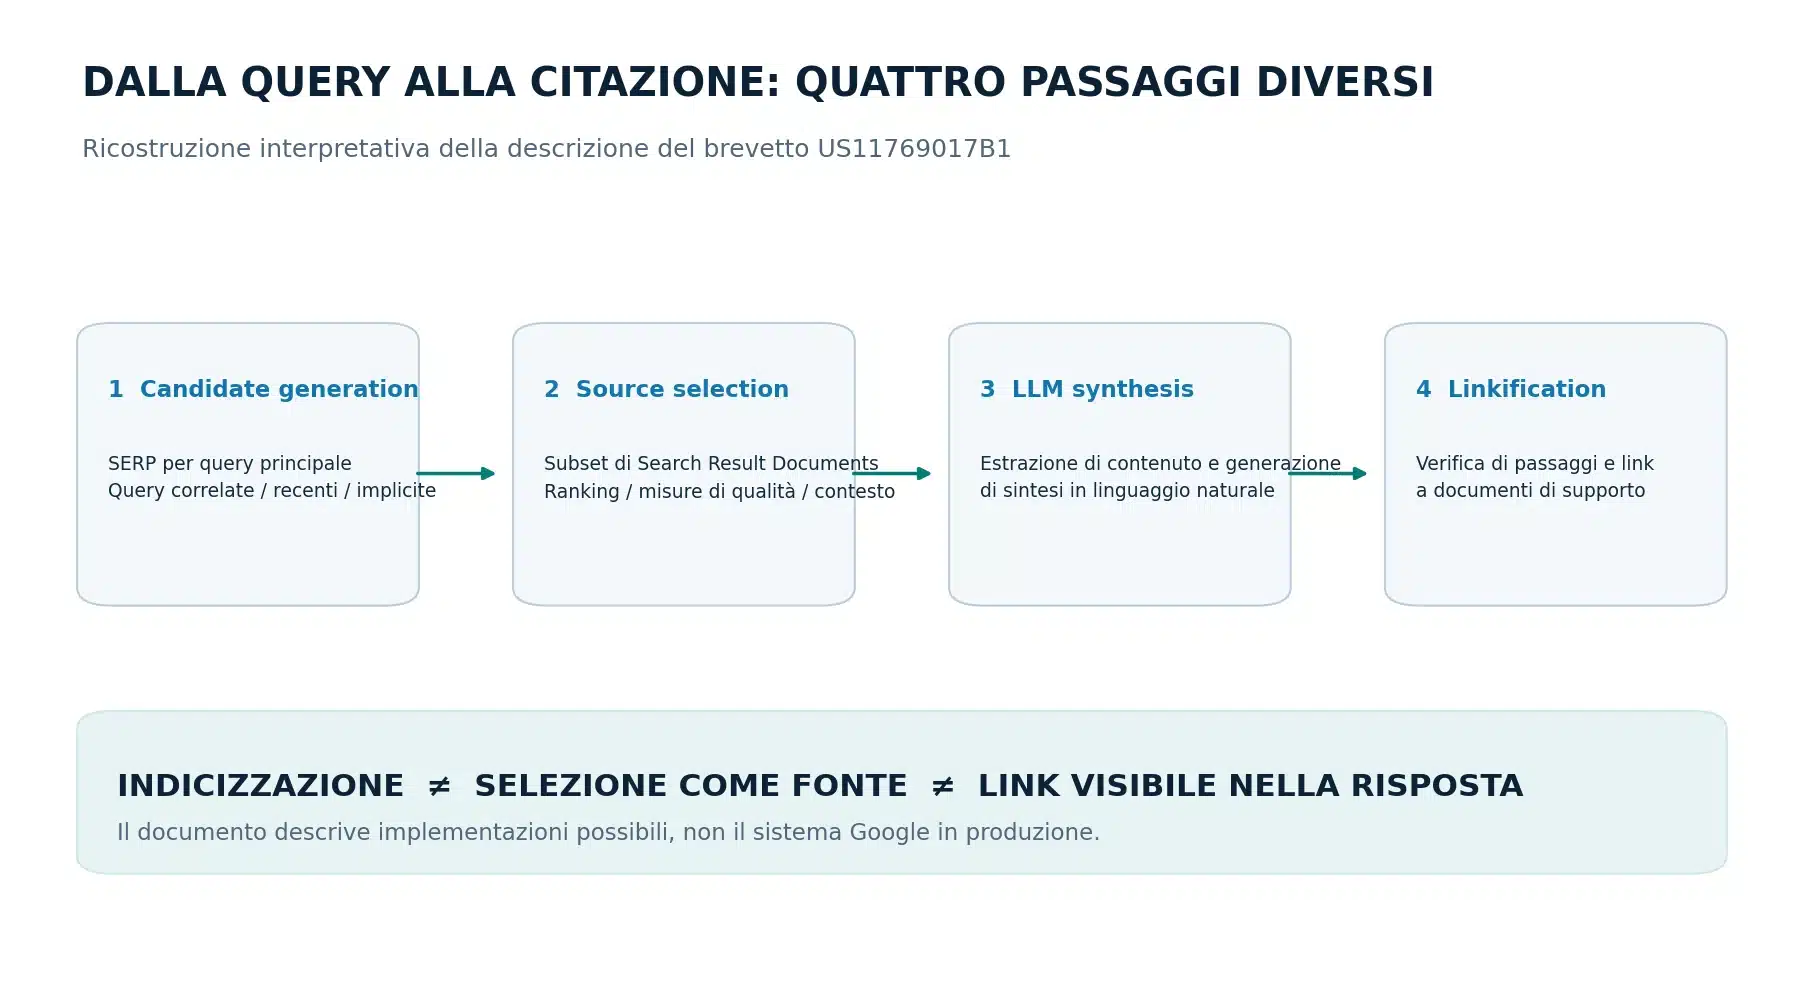
In un sistema RAG applicato alla ricerca possiamo separare almeno cinque stadi: candidate retrieval (insieme candidato), source selection (filtro e selezione), evidence extraction (passaggi utili), answer synthesis (generazione) e attribution/linking (collegamento delle affermazioni alle fonti). Questi nomi sono un modello di analisi costruito per leggere i documenti, non la denominazione ufficiale di una pipeline di produzione Google.
La presenza di una pagina nell’indice non ne garantisce il recupero per una query; il recupero non ne garantisce l’uso per costruire una frase; l’uso come evidenza non ne garantisce un link visibile. Di conseguenza ranking, coverage, citation rate e traffico sono grandezze diverse. Una strategia che le comprime in un solo KPI produce diagnosi sbagliate prima ancora di proporre ottimizzazioni.
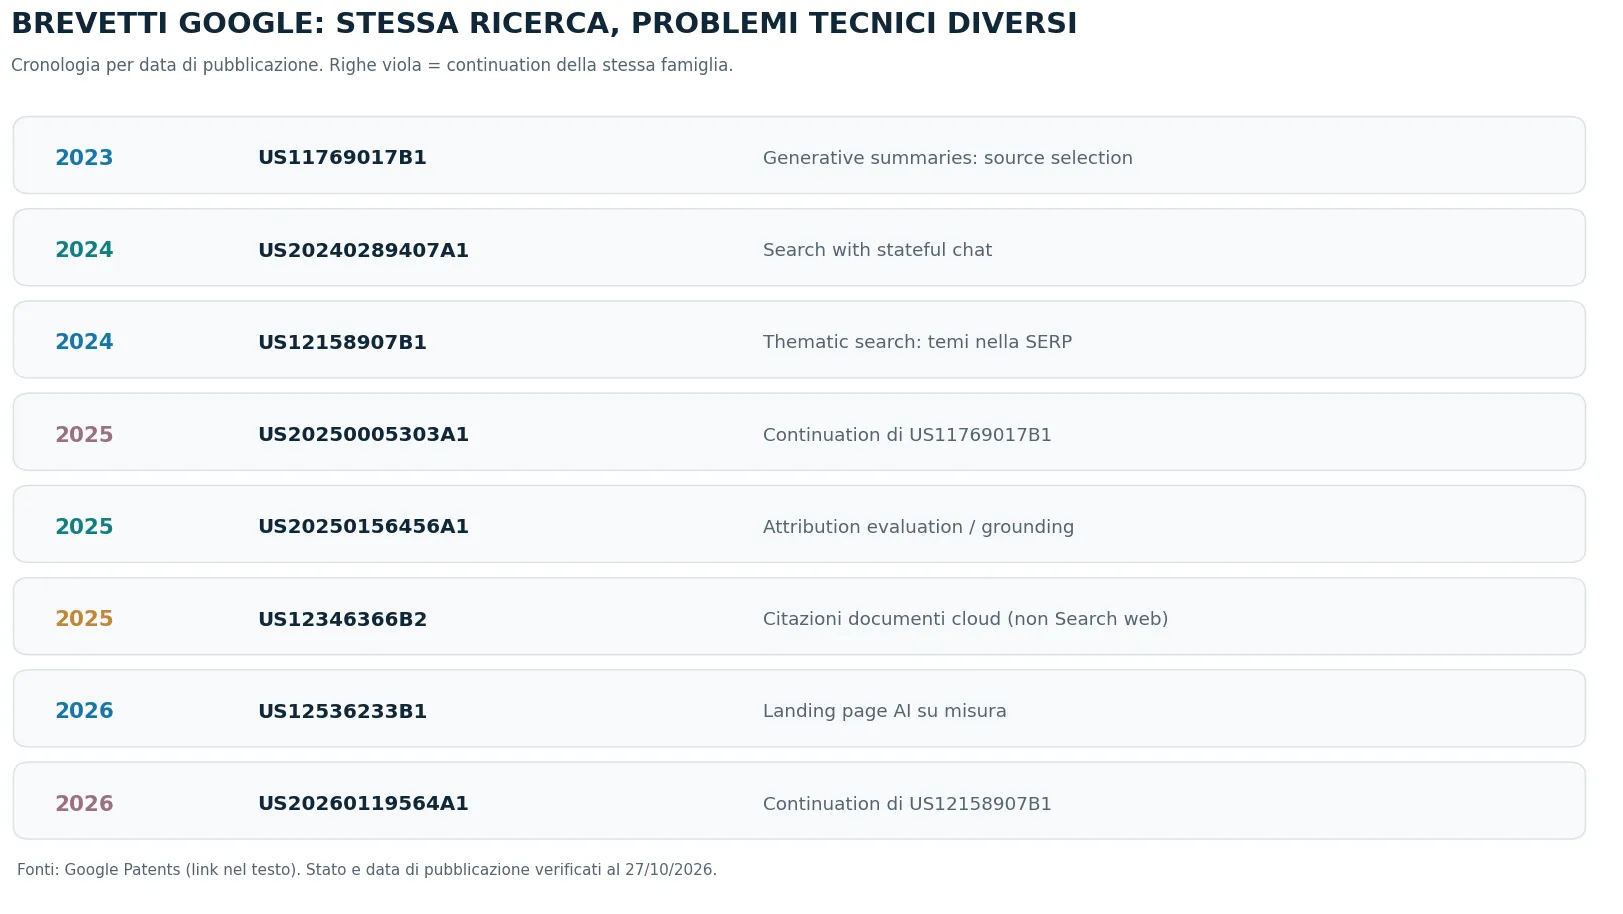
Otto pubblicazioni, sei filoni tecnici: cosa aggiunge ogni documento
La tabella riporta il titolare Google LLC, la data di pubblicazione e lo scopo effettivo dei testi. Due pubblicazioni sono continuation: vanno lette come estensioni giuridiche di famiglie precedenti, non come prove dell’arrivo di nuovi componenti della Search. Un ulteriore brevetto sul cloud aziendale è incluso come analogia tecnica, non come evidenza diretta della ricerca web. [1–7]
| Documento e pubblicazione | Oggetto verificabile | Come usarlo nella lettura SEO |
|---|---|---|
| US11769017B1 26/09/2023 |
Selezione di Search Result Documents per una sintesi LLM; query correlate e misure dei risultati. | Base della discussione su recupero, ranking e segnali candidati. |
| US20250005303A1 02/01/2025 |
Domanda di continuazione della stessa famiglia Generative summaries. | Non contarlo come seconda prova indipendente. |
| US12158907B1 / US20260119564A1 03/12/2024 e 30/04/2026 |
Thematic search: organizzazione di risultati in temi e gruppi, con continuazione nel 2026. | Spiega la logica dei sottotemi; non certifica l’algoritmo di AI Mode. |
| US20240289407A1 29/08/2024 |
Search with stateful chat: query e contesto conversazionale. | Interpretare sessioni e follow-up, senza proclamare personalizzazione universale. |
| US20250156456A1 15/05/2025 |
Large language model adaptation for grounding: valutazione dell’attribuzione delle affermazioni a passaggi documentali. | Distingue presenza di una citazione dalla qualità del suo supporto probatorio. |
| US12346366B2 01/07/2025 |
Risposte generative con citazioni a documenti di cloud storage, anche a porzioni. | Confronto tecnico sui passaggi citabili; non è un brevetto sul ranking delle pagine web. |
| US12536233B1 27/01/2026 |
Pagina AI generata in relazione a landing page e query utente, subordinata a un landing page score. | Ragionare su interfaccia e destinazioni generate, non presumere che Google riscriva oggi ogni sito. |
1. US11769017B1: ranking e segnali di selezione, ma nessun coefficiente SEO pubblico
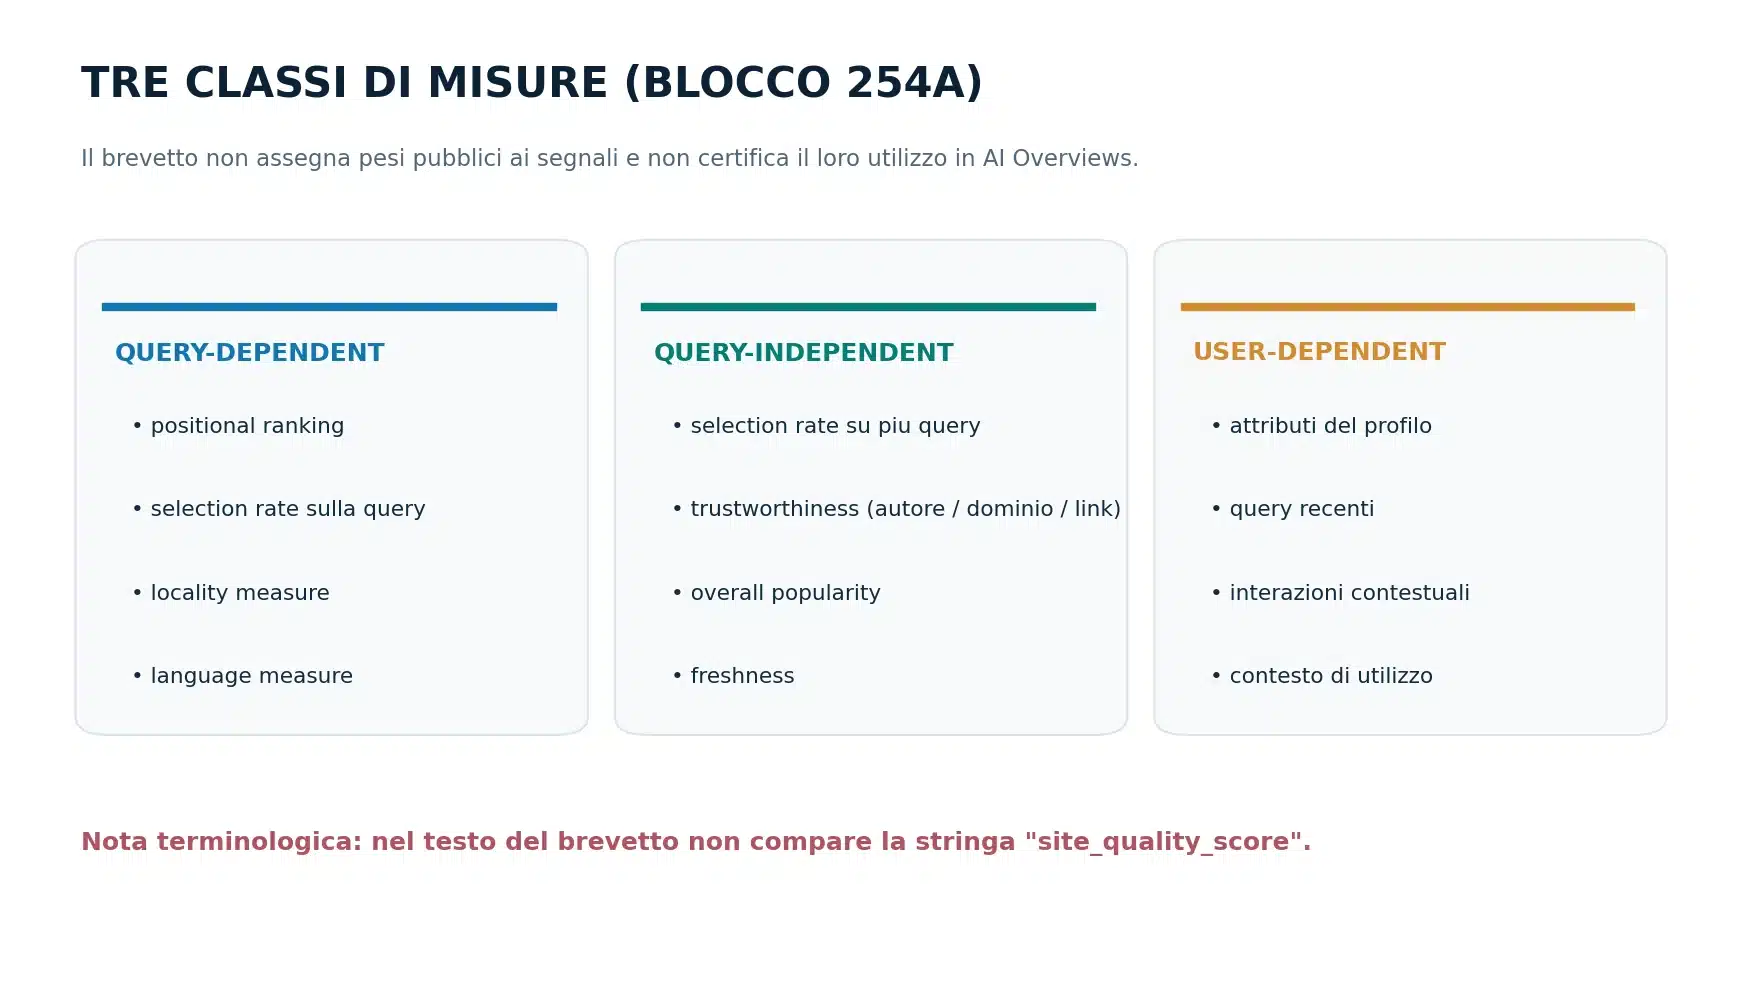
Il testo di Generative summaries for search results, soprattutto il blocco 254A del metodo 200, contempla tre insiemi di misure. Le query-dependent includono ranking posizionale, selection rate per query, località e lingua; le query-independent selection rate su più query, trustworthiness, popolarità e freshness; le user-dependent relazioni con il profilo, ricerche recenti e interazioni contestuali. [1]
Questo è il passaggio giusto da citare in un articolo tecnico, non il claim «Google usa il CTR per scegliere le AI Overviews». Selection rate non implica identità con il CTR esportato dalla Search Console, né una relazione causale per cui generare click artificiali aumenterebbe le citazioni. Anche site_quality_score, spesso aggiunto nelle sintesi social, non è la denominazione di una metrica riportata nel testo di questo brevetto.
Il documento contempla inoltre la selezione di SRD associati a related queries e, in certi casi, a interrogazioni recenti o implicite. Per la SEO è la differenza tra possedere una pagina rilevante per la query letterale e disporre di risorse che rispondono ai sotto-bisogni generati dal contesto. Anche qui, però, il brevetto descrive opzioni implementative: non è un log dei sistemi Google attivi nel 2026.
2. Thematic search e chat stateful: dal documento alla distribuzione dei sotto-intenti
Il brevetto US12158907B1 e la continuazione US20260119564A1 descrivono l’estrazione di themes dai documenti di ricerca e la presentazione dei risultati raggruppati per argomento. Nel testo compare un esempio di ricerca su un trasferimento a Milwaukee, articolata per quartieri, costo della vita e attività. È un indizio tecnico su una possibile interfaccia tematica, non una dimostrazione che query fan-out e thematic search siano la stessa tecnologia. [3]
US20240289407A1, invece, riguarda la ricerca con chat dotata di stato, nella quale i turni successivi possono beneficiare del contesto. Questa continuità conversazionale cambia il problema di retrieval: a parità di frase, un follow-up può rappresentare bisogni diversi a seconda del dialogo precedente. [4]
Implicazione pratica: mappare un intent graph con bisogni informativi collegati, non moltiplicare meccanicamente URL per ogni formulazione. Contenuti diversi hanno senso quando cambia la domanda, la prova richiesta o il dataset; se cambia solo la superficie lessicale, la proliferazione di pagine rischia cannibalizzazione e scarso valore aggiunto.
3. Grounding e attribution: il problema non è avere un link, ma sostenere un’affermazione
La domanda US20250156456A1 propone un sistema che valuta una risposta generata attraverso un attribution evaluation model: affermazioni dell’output vengono confrontate con evidence passages e una misura della grounding quality può entrare nell’adattamento del modello. È un documento molto più pertinente per discutere l’affidabilità delle citazioni che per immaginare una nuova formula di ranking web. [5]
Nel brevetto US12346366B2 alcune rivendicazioni prevedono citazioni non solo al documento, ma anche a una sua porzione. Attenzione al contesto: si tratta di documenti conservati in una piattaforma cloud collaborativa, con accessi e permessi. Sarebbe scorretto dedurne che Google Search usa esattamente lo stesso componente sui siti pubblici. Serve però a capire una distinzione di ingegneria dell’informazione: document-level retrieval e passage-level attribution sono livelli differenti. [6]
Per un editore questa distinzione suggerisce una prassi verificabile: attribuire numeri a dataset, dichiarare campioni e date, segnalare aggiornamenti sostanziali, distinguere descrizioni da inferenze e fornire un contesto sufficientemente completo intorno a ogni affermazione. Non perché sia stato dimostrato un «bonus citazione» per una certa lunghezza del paragrafo, ma perché queste caratteristiche rendono migliore la verificabilità delle informazioni.
4. Il brevetto 2026 sulle pagine AI non descrive semplicemente una nuova AI Overview
US12536233B1 («AI-generated content page tailored to a specific user») contempla un landing page score e, al superamento di una soglia, la disponibilità nella SERP di un link verso una pagina generata su misura. È una proposta diversa dal classico pannello riassuntivo: qui entra in gioco un’interfaccia di destinazione, non solo una risposta testuale con collegamenti. [7]
Io lo ha già analizzato nel pezzo del 4 marzo 2026 sul brevetto US12536233B1. Per questa ragione non serve ripetere il documento in chiave sensazionalistica; il punto nuovo è confrontare tre livelli: documento di partenza, risposta attribuita e pagina sintetica costruita per l’utente. Le conseguenze commerciali sarebbero molto diverse, ma la concessione del brevetto non certifica una distribuzione generale della funzionalità.
Il controllo con le fonti ufficiali: che cosa Google ammette nel 2026
Il 15 maggio 2026 Google ha pubblicato una guida dedicata alle funzionalità generative della Search. Dice esplicitamente che le AI features poggiano sui sistemi core di ranking e qualità, che fanno ricorso a RAG e query fan-out, e che per comparire come link di supporto servono le normali condizioni di indicizzazione ed eleggibilità degli snippet. Precisa anche che non esiste un requisito speciale per file llms.txt o markup esclusivi per AI Overviews. [8]
Non è una garanzia di citazione. È un confine tecnico chiaro: prima di inventare nuove micro-tattiche GEO, occorre controllare la retrieval readiness di un URL (canonical, contenuto testuale accessibile, indicizzazione, snippet controls, pagine raggiungibili e presenza di informazioni originali).
15 ottobre 2026: Google interviene sull’interfaccia delle fonti, non dichiara un nuovo fattore di ranking
Il 15 ottobre 2026 Google ha annunciato More ways to connect with the web from Search, un aggiornamento esplicito delle superfici di attribuzione in AI Overviews e AI Mode. La comunicazione distingue cinque interventi: maggiore presenza e visibilità dei link inline all’interno delle risposte; test di una sezione prominente per siti ufficiali utili a completare un’azione; estensione internazionale dei caroselli per notizie tempestive; collegamenti di approfondimento con miniature; sperimentazione dei profili cliccabili di creator e publisher nei risultati video di AI Mode. Non tutte le funzionalità sono dichiarate disponibili ovunque e il test sui siti ufficiali non costituisce una regola generale per ogni query. [14]
Questo aggiornamento aggiunge al modello dell’articolo una variabile che non può essere ignorata: l’esposizione della fonte dipende anche dal formato di presentazione. Un URL può essere recuperato e perfino citato, ma link inline, card prominente, carosello editoriale e suggerimento finale non hanno necessariamente lo stesso potenziale di interazione. Il brevetto discute l’architettura della sintesi; il post di ottobre documenta invece una modifica reale di prodotto. Non dimostra che Google abbia modificato il ranking dei documenti candidati.
Dal punto di vista operativo conviene rilevare separatamente, nei controlli periodici: presenza del dominio nella risposta, tipo di collegamento, posizione del collegamento nell’interfaccia e contenuto del passaggio supportato. Le Preferred Sources non vanno assimilate a un backlink o a un segnale algoritmico di trust: Google descrive una funzionalità che consente alle persone di indicare fonti gradite, senza pubblicare una formula di selezione. [14]
I dati recenti: il rischio non riguarda più solo le query informative
Pew 2025: meno click nelle sessioni in cui compare la sintesi
Nell’analisi Pew di 68.879 ricerche condotte nel marzo 2025 da 900 adulti USA, una visita a risultati con AI summary ha registrato un clic su un risultato tradizionale nell’8% dei casi, contro il 15% senza summary; i link interni alle sintesi sono stati cliccati nell’1% delle visite che le mostravano. Sono percentuali osservazionali, non una dimostrazione di causalità. [9]
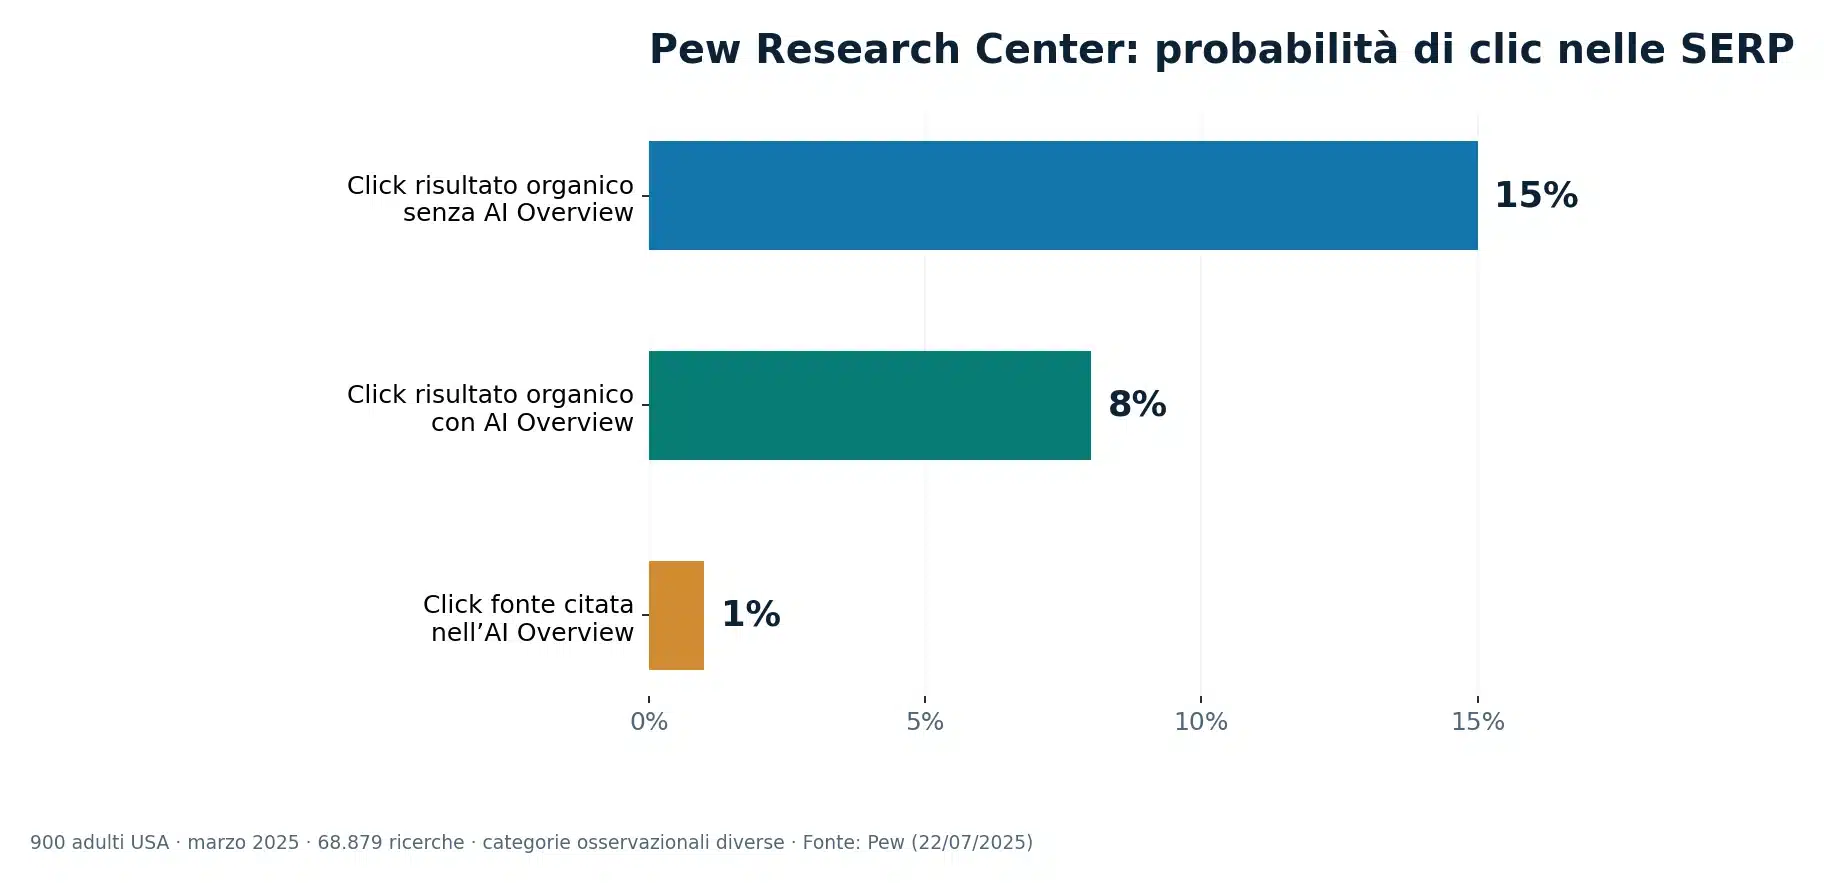
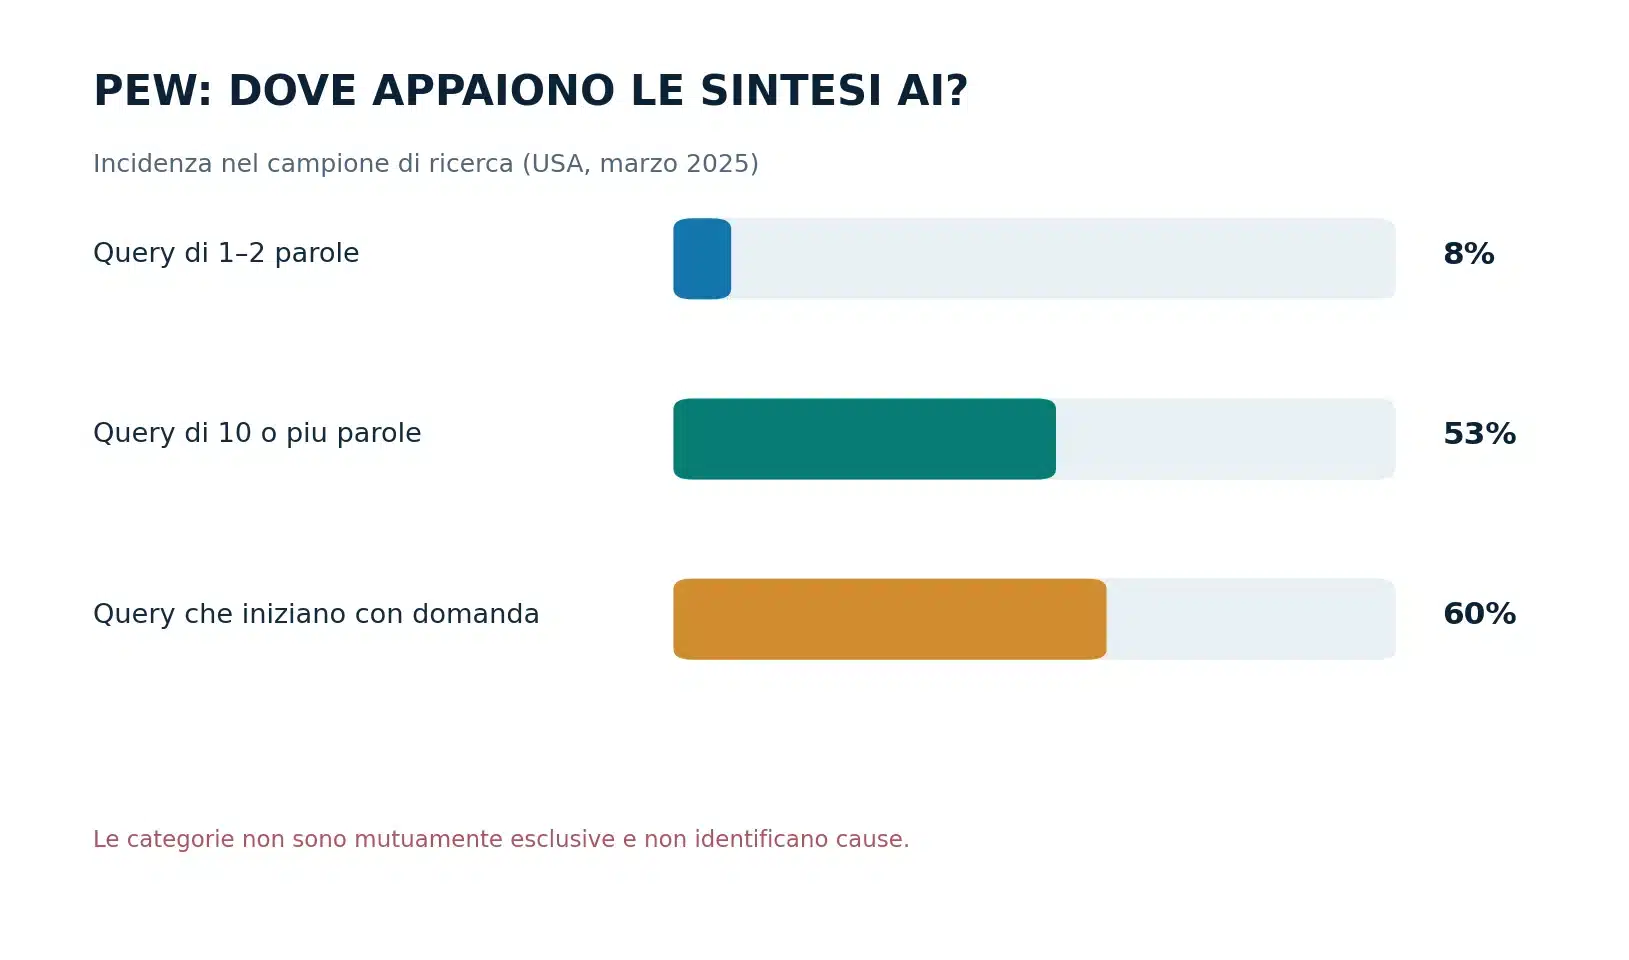
La presenza delle sintesi non è omogenea per intento: Pew rileva, per il campione esaminato, differenze importanti tra query brevi, interrogazioni lunghe e ricerche in forma di domanda. Queste categorie si sovrappongono: non sono percentuali sommabili.
Ahrefs febbraio 2026: −58% di CTR stimato per il risultato in posizione uno
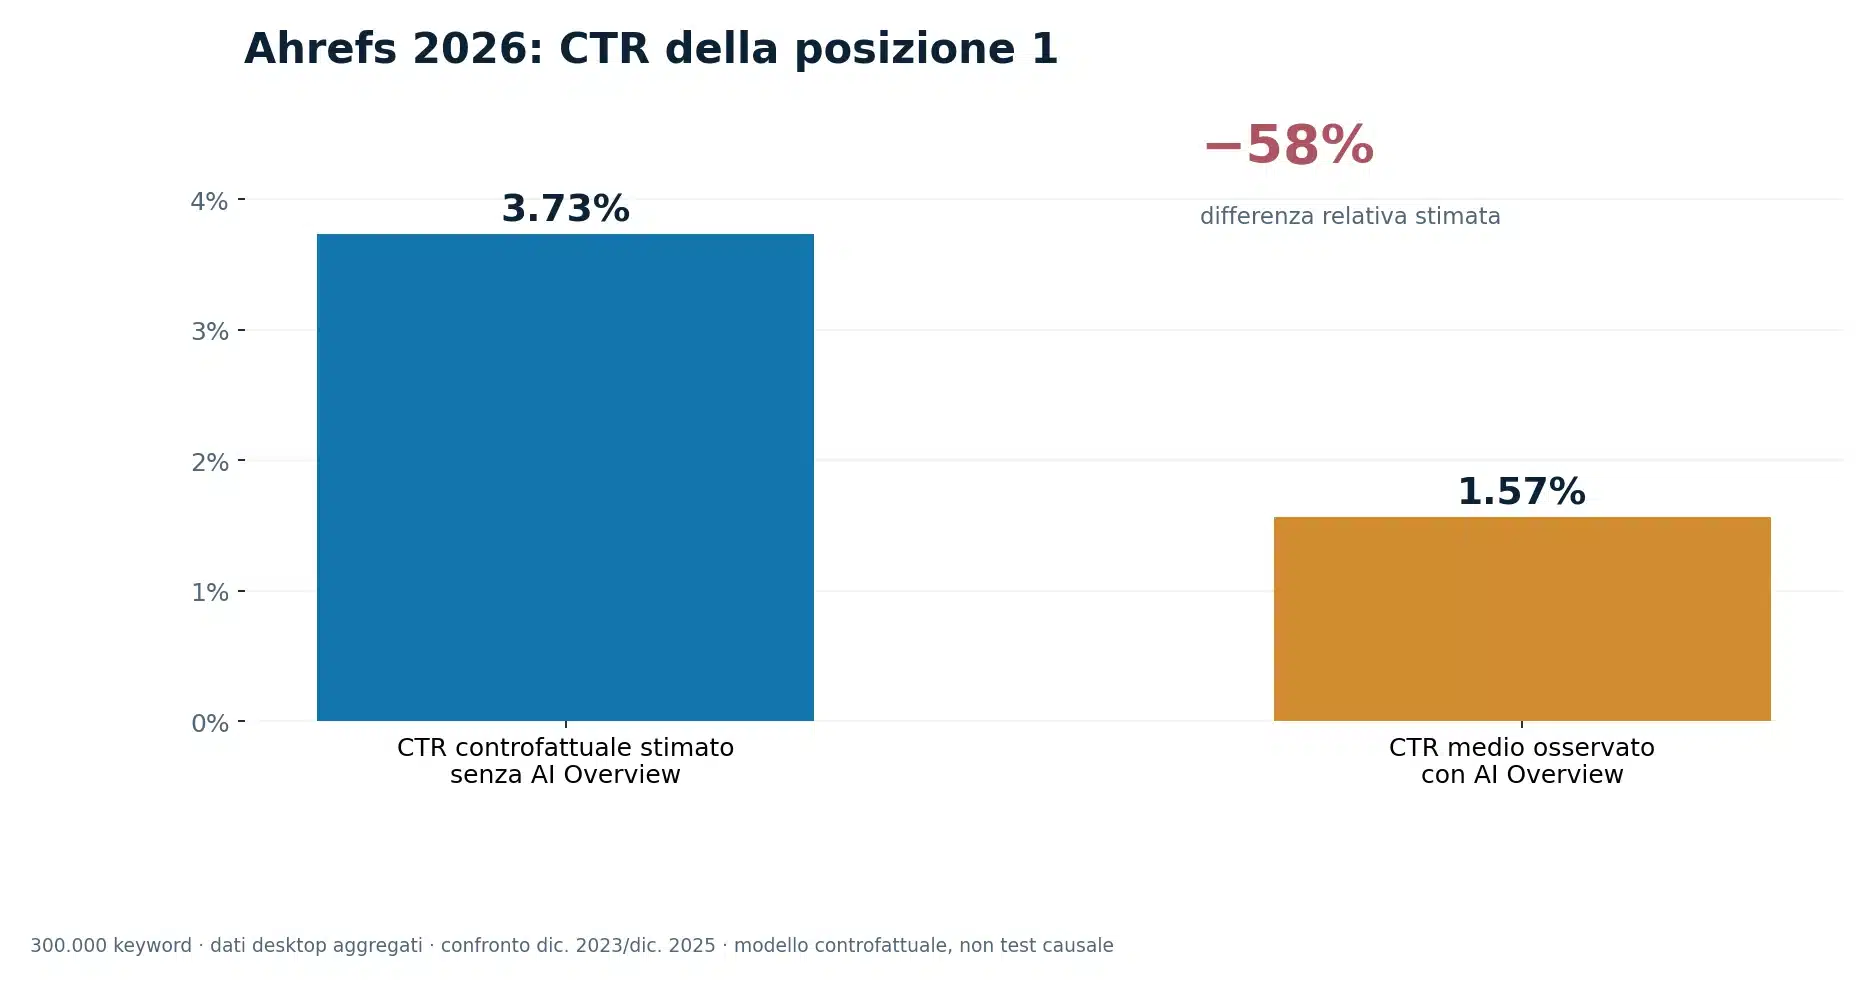
Ahrefs ha ri-eseguito un’analisi su 300.000 keyword con dati del dicembre 2025 e ha riportato un CTR medio associato alla presenza di AI Overviews inferiore del 58% rispetto a un valore controfattuale stimato. L’espressione corretta è correlazione stimata sul campione, non «Google taglia del 58% il traffico di ogni sito». [10]
Ahrefs ottobre 2026: la brand SERP entra nella partita
Il dato nuovo è del 2 ottobre 2026: Ahrefs ha analizzato 232,8 milioni di acquisizioni SERP da desktop USA nel periodo luglio-settembre. Nel suo campione la quota mensile delle keyword di brand associate ad AI Overview è passata dal 61,3% di luglio al 65,1% di agosto e al 73,3% di settembre; il 29 settembre il valore giornaliero indicato era l’82,91%. Non bisogna confondere quest’ultimo con la media del mese né generalizzarlo a mobile o Italia. [11]
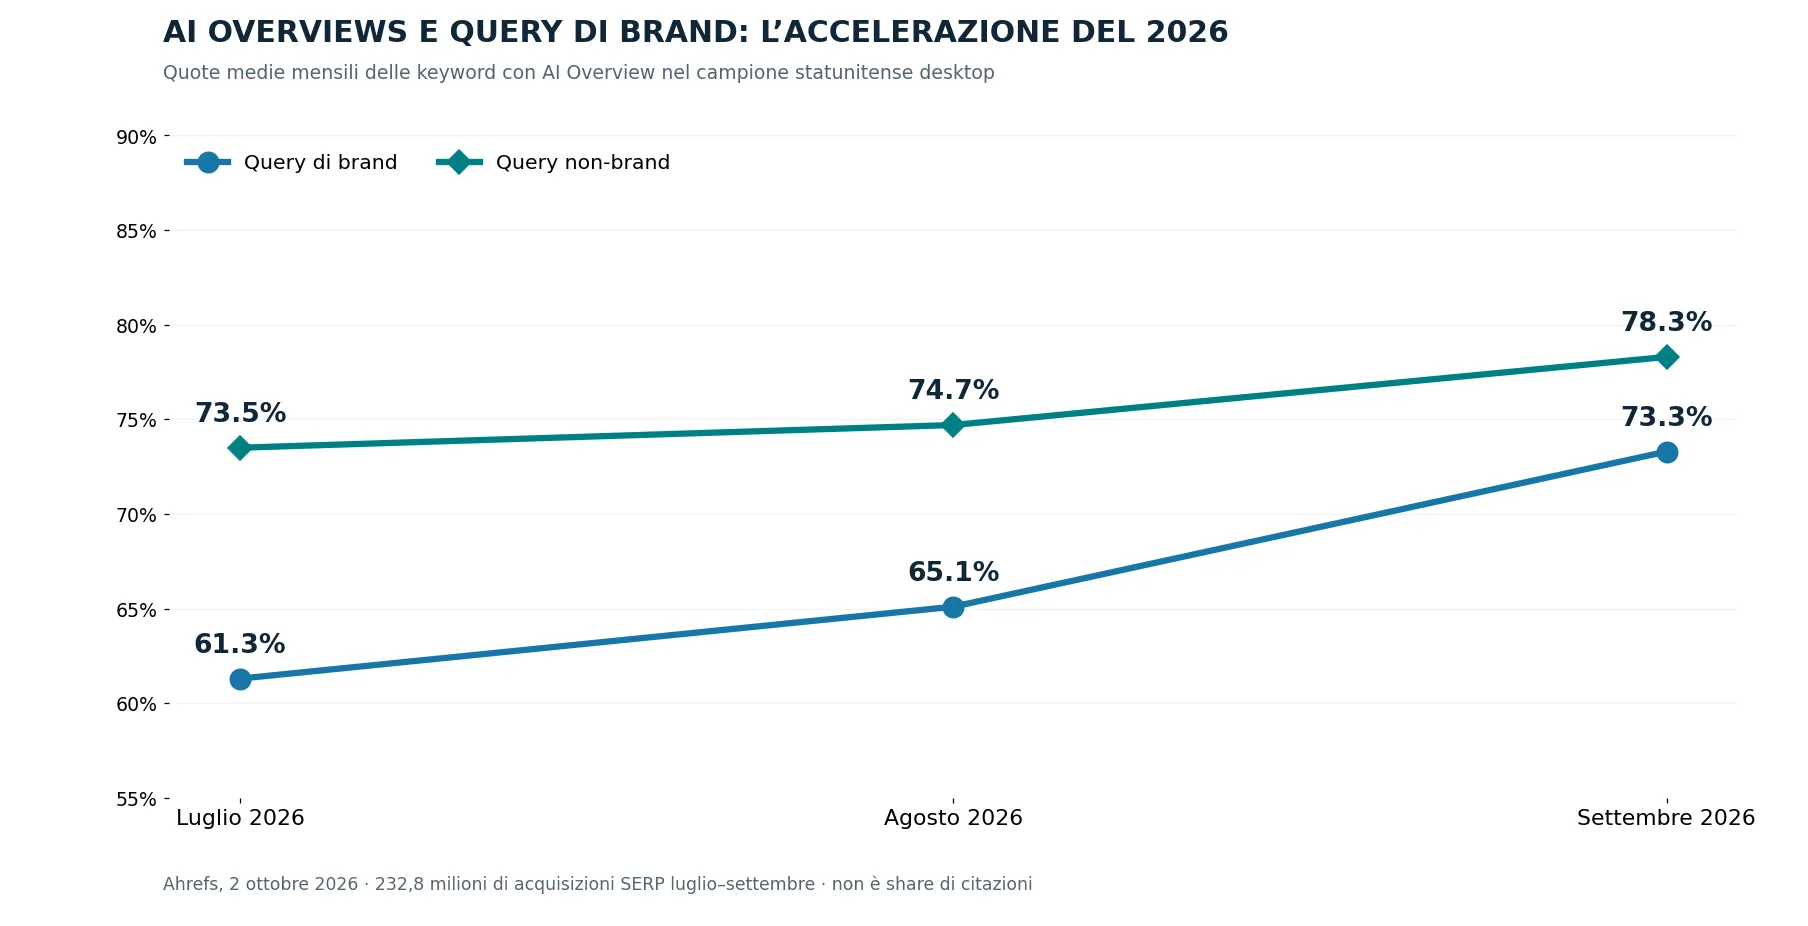
Il rischio di source attribution si sposta così anche sulla SERP navigazionale: per definire un’organizzazione, una risposta AI può utilizzare fonti terze, inclusi Wikipedia, YouTube e LinkedIn. L’audit non deve limitarsi a «siamo primi sul nostro marchio»: occorre controllare come l’entità viene descritta e quali documenti sostengono informazioni non aggiornate o inesatte.
Search Console e misurazione: tre eventi che nel 2026 hanno cambiato l’osservabilità
Dal 3 giugno 2026 Google ha introdotto report dedicati alle impression delle funzionalità generative, completandone la distribuzione globale il 31 agosto. La documentazione descrive dimensioni relative a pagine, Paesi, dispositivi e tempo, ma non un export del selection rate dell’algoritmo né una mappatura completa query × frase citata. [12]
Il 24 settembre 2026 Google ha annunciato un filtro per le ricerche multimodali web nei report di Search Console, compresi quelli delle funzionalità AI. Questo aggiunge una variabile di contesto: in certi verticali il retrieval parte da immagini, Lens o Circle to Search, non soltanto da parole digitate. [13]
Per confronto, nel mio articolo Topics Portfolio di Bing Webmaster Tools del 14 ottobre 2026: le grounding queries e le query di opportunità in quel report riguardano l’ecosistema Microsoft, non sono trasferibili numericamente a Google. Proprio questa asimmetria richiede un protocollo di rilevazione distinto per piattaforma.
| Indicatore | Fonte possibile | Cosa misura realmente | Limite |
|---|---|---|---|
| Impression AI di un URL | Search Console, report generative AI | Presenza dell’URL nelle funzioni AI monitorate | Non misura contributo alla risposta |
| Citazione osservata in test controllato | Panel manuale di query e screenshot | Link o dominio apparso nella risposta del test | Varianza per sessione, mercato, tempo e device |
| Copertura di fan-out / topic | Mappa di intenti + query di verifica | Ampiezza dei bisogni coperti da contenuti propri | Le sottoquery effettive di Google non sono interamente osservabili |
| Visite e conversioni | Analytics + backend aziendale | Risultato economico post-visita | Attribuzione incompleta per zero-click e branded demand |
22 ottobre 2026: AI Share of Voice non equivale a citation rate né a quota di traffico
Una guida metodologica di Ahrefs del 22 ottobre 2026 dettaglia un ulteriore problema di misurazione: l’AI Share of Voice confronta la presenza di un marchio nelle risposte di un insieme definito di prompt e concorrenti. La metrica può essere ponderata con stime della domanda, ma resta un indicatore relativo alla selezione di prompt, piattaforme, mercati e soggetti confrontati. Cambiando il paniere o i concorrenti cambia anche la percentuale, senza che sia necessariamente cambiata la visibilità effettiva. [15]
La separazione dei KPI, quindi, deve essere rigorosa: brand mention rate ≠ URL citation rate ≠ impression AI certificate dalla Search Console ≠ sessioni e conversioni. Un test ripetibile dovrebbe fissare per ogni rilevazione lo stesso prompt set, Paese, lingua, device, periodo e set competitivo, archiviando esempi di risposta e differenziando i link alla fonte dalle semplici menzioni del brand. I valori stimati da provider esterni non sono contatori ufficiali di utenti raggiunti. Questa è un’indicazione di metodo, non la presentazione di un nuovo algoritmo Google.
Metodo DeepSEO: audit delle evidenze e priorità, non caccia ai «fattori AI»
Il mio criterio è dividere l’audit in tre layer, ciascuno verificabile con dati propri. Layer retrieval: URL canonici, accessibilità HTML, indexability, intent map, prossimità semantica delle informazioni e conflitti tra versioni. Layer evidence: origine dei fatti, date di rilevazione, metodologia, contesto, coerenza tra passaggi e marcatori di identità delle entità. Layer measurement: impression AI, campionamento ripetuto delle citazioni, dati delle SERP di brand e risultati economici.
Per un sito B2B la domanda prioritaria potrebbe essere: «quali frasi su prezzi, compatibilità e procedure del prodotto possono essere sostenute oggi da pagine pubbliche datate e verificabili?». Per un editore: «quali dati originari pubblichiamo che una sintesi non possa ricostruire soltanto aggregando i concorrenti?». Per un brand: «quale fonte esterna rischia di definire la nostra identità nella SERP navigazionale?». Sono domande diverse, dunque richiedono audit differenti.
Questa impostazione è coerente con la guida ufficiale Google, che chiede contenuti utili e distintivi e sconsiglia tattiche che si limitano a inseguire varianti artificiali delle query. Non autorizza però a promettere più citazioni, né consente di spacciare una checklist per un reverse engineering dell’algoritmo.
Cosa avevamo già approfondito su DeepSEO e cosa aggiunge questa analisi
Il percorso parte da Svelato il brevetto su Google SGE (1 dicembre 2023), prosegue con Google AI Overview in Italia, con l’analisi del brevetto sulle pagine AI personalizzate (4 marzo 2026), e arriva alle ricadute per editori di Google AI Contribution (15 settembre 2026) e alle opportunità di Topics Portfolio (14 ottobre 2026).
Questo articolo non sostituisce quei pezzi: serve a collegare criticamente i brevetti in un modello end-to-end, evidenziare ciò che è realmente coperto dalle rivendicazioni, escludere le interpretazioni troppo forti e integrare la ricerca empirica più recente sulle SERP di brand.
La citazione non è un ranking, e il brevetto non è l’algoritmo
Se un brevetto contempla ranking, clic e fiducia come possibili misure, non segue che nel 2026 quelle misure decidano in modo meccanico le fonti di AI Overviews. Se una domanda di grounding allena un modello a sostenere affermazioni con passaggi, non segue che quella domanda sia il componente online di Google Search. E se una SERP mostra più risposte AI, non segue che ogni sito perda traffico in proporzione al medesimo coefficiente.
Il cambiamento sostanziale è un altro: la SEO deve controllare qualità del documento recuperabile, verificabilità dei passaggi e impatto economico della visibilità, senza confonderli. La prossima competenza non è inventare segnali nascosti; è progettare fonti migliori e misurare dove, quando e per quale bisogno il sistema le utilizza.
Fonti primarie
- Google Patents, US11769017B1, Generative summaries for search results, concesso 26/09/2023; metodo 200 e blocco 254A.
- Google Patents, US20250005303A1, continuazione di Generative summaries, pubblicata 02/01/2025; stato della domanda verificato 27/10/2026.
- Google Patents, US12158907B1, Thematic search, concesso 03/12/2024; e US20260119564A1, continuazione pubblicata 30/04/2026.
- Google Patents, US20240289407A1, Search with stateful chat, pubblicata 29/08/2024.
- Google Patents, US20250156456A1, Large language model adaptation for grounding, pubblicata 15/05/2025.
- Google Patents, US12346366B2, Providing generative answers including citations to source documents, concesso 01/07/2025. Ambito: documenti in cloud storage; non Search web.
- Google Patents, US12536233B1, AI-generated content page tailored to a specific user, concesso 27/01/2026.
- Google Search Central, Optimizing your website for generative AI features on Google Search, risorsa pubblicata 15/05/2026, verificata 27/10/2026.
- Pew Research Center, 22/07/2025; panel USA, 900 adulti, 68.879 ricerche.
- Ahrefs, Ryan Law, Update: AI Overviews Reduce Clicks by 58%, 04/02/2026.
- Ahrefs, Ryan Law, AI Overviews Currently Appear for 83% of Branded Searches, 02/10/2026; 232,8 milioni di acquisizioni SERP USA desktop.
- Google Search Central Blog, Introducing Search Generative AI performance reports in Search Console, 03/06/2026, rollout globale 31/08/2026.
- Google Search Central Blog, Announcing web multimodal Search performance reporting in Search Console, 24/09/2026.
- Google Blog, Hema Budaraju, More ways to connect with the web from Search, 15/10/2026. Aggiornamenti di interfaccia per link inline, siti ufficiali, news carousel e profili creator; distinguere rollout e test.
- Ahrefs, Si Quan Ong, AI Share of Voice: What It Is, How to Measure It, and What It Actually Tells You, 22/10/2026. Guida metodologica: KPI relativo ai prompt campionati, non dato di traffico.