Lens, Circle to Search, upload di immagini e “Search this image” diventano finalmente misurabili. Il punto, però, non è soltanto il nuovo filtro: cambia il modo in cui dobbiamo leggere la visibilità quando la ricerca parte da ciò che l’utente vede.
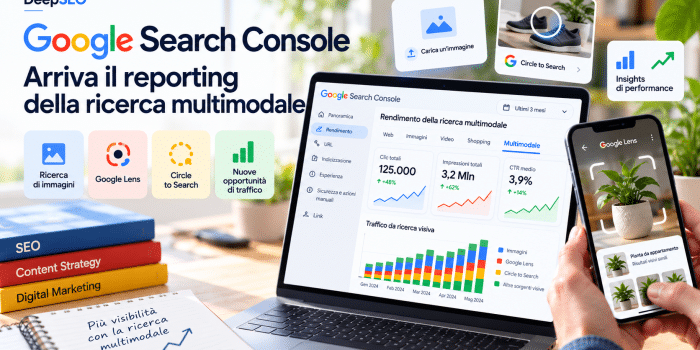
Lens, Circle to Search, upload di immagini e “Search this image” diventano finalmente misurabili. Il punto, però, non è soltanto il nuovo filtro: cambia il modo in cui dobbiamo leggere la visibilità quando la ricerca parte da ciò che l’utente vede.
Google sta testando un modello in cui un contenuto può avere un valore economico anche quando l’utente non lo clicca. È questo, più del pagamento in sé, l’aspetto interessante di AI Contribution.
Il 14 settembre 2026 Digiday ha pubblicato nuovi dettagli sul pilot: alcuni publisher invitati vedono in Search Console un pannello dedicato ai guadagni maturati quando i loro contenuti contribuiscono in modo “significativo” a risposte generate in Gemini, AI Overview e AI Mode. Search Engine Roundtable ha ripreso la documentazione mostrata ai partecipanti e chiarisce un punto importante: non tutte le citazioni valgono come contribution. Il programma guarda alla fase in cui il contenuto influenza la risposta generata; un link mostrato dopo, o una pagina usata solo per confermare un fatto, può non qualificarsi. [1][2]
Questo dettaglio cambia il modo in cui conviene leggere la SEO per la ricerca generativa. Fino a oggi abbiamo misurato ranking, impression, click e, più recentemente, citazioni AI. AI Contribution introduce un altro livello: il valore informativo che una pagina porta dentro il processo di generazione. Read More
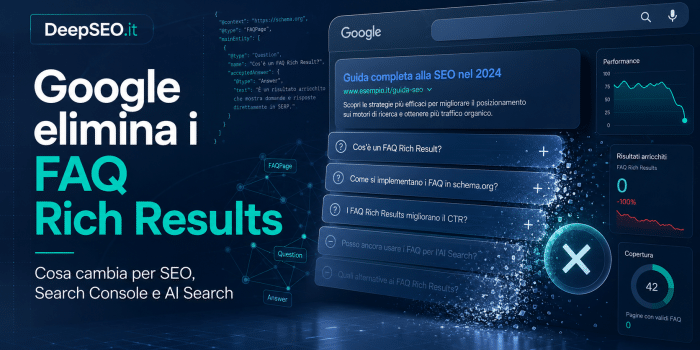
Google ha aggiornato la documentazione ufficiale comunicando che, dal 7 maggio 2026, i risultati avanzati basati sulle FAQ non vengono più mostrati nella Ricerca Google.
Il cambiamento riguarda tre livelli:
Per molti siti, però, l’impatto reale sarà inferiore al rumore della notizia. Google aveva già ridotto pesantemente la visibilità delle FAQ in SERP nel 2023. La rimozione del 2026 è quindi meno una rivoluzione improvvisa e più la chiusura definitiva di una fase già iniziata da tempo.
Google ha distribuito la rimozione su più momenti, separando la parte visiva dalla parte di reporting e dalla parte API.
| Data | Cosa cambia | Impatto SEO |
|---|---|---|
| 7 maggio 2026 | I FAQ rich results non appaiono più nella Ricerca Google | Le FAQ non occupano più spazio aggiuntivo sotto lo snippet organico |
| Giugno 2026 | Rimozione dei report dedicati e del supporto nel Rich Results Test | Search Console non mostrerà più enhancement e search appearance specifici |
| Agosto 2026 | Rimozione del supporto nella Search Console API | Dashboard, script e sistemi di reporting automatizzati dovranno essere aggiornati |
La distinzione è importante. Un sito può perdere una feature visiva senza subire un calo di ranking. Allo stesso modo, la scomparsa di un report in Search Console non significa che Google smetta di leggere completamente i dati strutturati presenti nella pagina.
Il punto tecnico centrale è questo: FAQ rich result e FAQPage schema non sono la stessa cosa.
Il FAQ rich result era il formato visuale che Google poteva mostrare in SERP: una serie di domande espandibili sotto il risultato organico. Era una feature di presentazione, controllata da Google e concessa solo quando il motore decideva di mostrarla.
FAQPage, invece, è un tipo di dato strutturato definito da Schema.org. Serve a descrivere una pagina che contiene domande frequenti e relative risposte.
La differenza è sostanziale:
Questa distinzione dovrebbe guidare ogni decisione operativa. Chi rimuove tutto in blocco rischia di confondere un cambiamento di interfaccia con un cambiamento di linguaggio semantico.
Google non ha bisogno di spiegare ogni modifica della SERP con un documento strategico. Tuttavia, osservando l’evoluzione degli ultimi anni, la direzione è abbastanza chiara.
I FAQ rich results erano diventati una leva SEO troppo facile da replicare. Bastava aggiungere alcune domande in fondo a una pagina, implementare il markup corretto e sperare di occupare più spazio nella SERP.
Il problema non era il formato in sé. Le FAQ possono essere utilissime. Il problema era l’uso industriale della feature: domande generiche, risposte banali, keyword mascherate da contenuto utile, blocchi inseriti solo per ottenere più pixel nei risultati di ricerca.
Quando una feature nasce per aiutare l’utente ma viene trasformata in una scorciatoia tattica, Google tende a fare tre cose:
È esattamente ciò che è successo con le FAQ. Nel 2023 Google aveva già limitato fortemente la visualizzazione dei rich results FAQ, riservandoli soprattutto a siti governativi e sanitari autorevoli. Nel 2026 la feature viene ritirata del tutto.
La perdita principale riguarda lo spazio visivo in SERP. Quando le FAQ venivano mostrate, il risultato organico poteva diventare più alto, più evidente e più ricco rispetto ai risultati concorrenti.
Questa espansione poteva avere effetti su:
Ma bisogna evitare letture semplicistiche. La rimozione dei FAQ rich results non equivale a una penalizzazione. Non significa che le pagine con FAQ perdano ranking. Non significa che il markup FAQ sia diventato un segnale negativo.
Significa che una specifica leva di presentazione non è più disponibile.
In pratica, il ranking continua a dipendere da pertinenza, qualità del contenuto, intento di ricerca, autorevolezza, esperienza utente, segnali tecnici e contesto competitivo. Le FAQ non vengono più premiate con un formato visuale dedicato, ma una pagina ben strutturata resta una pagina più leggibile, più utile e potenzialmente più forte.
Per gran parte dei siti commerciali, editoriali, affiliati ed e-commerce, i FAQ rich results erano già scomparsi o diventati estremamente rari dopo l’aggiornamento del 2023.
Questo significa che il calo non si vedrà necessariamente nei dati di maggio 2026. In molti casi il calo reale è già avvenuto tra il 2023 e il 2024, quando Google ha iniziato a mostrare le FAQ solo in contesti molto limitati.
Per questo motivo, chi analizza il traffico deve fare attenzione a non attribuire automaticamente ogni variazione organica alla rimozione del supporto FAQ.
Un calo di traffico nel periodo può dipendere da:
L’errore classico sarebbe guardare una linea discendente in Search Console e dire: “È colpa delle FAQ”. Serve invece un’analisi per query, pagina, periodo, paese e dispositivo.
La parte meno spettacolare, ma più importante per chi fa SEO in modo professionale, riguarda Search Console.
Google rimuoverà i report dedicati ai FAQ rich results. Questo significa che non sarà più possibile usare quella specifica search appearance per analizzare impression, click, CTR e posizione media delle pagine che avevano generato risultati FAQ.
Per siti piccoli può sembrare un dettaglio. Per siti grandi, agenzie, network editoriali ed e-commerce con report automatici, invece, è un punto operativo rilevante.
Bisogna controllare:
Il rischio non è solo perdere un dato. Il rischio è mantenere in vita metriche che non significano più nulla, generando report sporchi, errori API o interpretazioni sbagliate.
La risposta più corretta è: dipende dalla qualità del markup e dallo scopo delle FAQ.
Rimuovere automaticamente tutti i dati strutturati FAQ è una reazione eccessiva. Google aveva già chiarito nel 2023 che i dati strutturati non utilizzati per un rich result non creano problemi alla Ricerca, purché siano corretti e coerenti con il contenuto visibile.
In generale:
La domanda non deve essere: “Google mostra ancora il rich result?”
La domanda deve essere: “Queste FAQ migliorano davvero la pagina?”
La rimozione dei rich results obbliga a separare le FAQ editoriali dalle FAQ cosmetiche.
Le FAQ editoriali rispondono a domande reali. Nascono da dati di customer care, query di ricerca, obiezioni commerciali, conversazioni con gli utenti, recensioni, ticket, call sales, chat interne o analisi dei competitor.
Le FAQ cosmetiche, invece, vengono inserite solo per allungare la pagina o intercettare keyword long tail. Sono spesso generiche, ripetitive e intercambiabili tra decine di URL.
Esempio di FAQ debole:
Domanda: Perché scegliere il nostro servizio?
Risposta: Perché offriamo qualità, professionalità e convenienza.
Questa FAQ non aggiunge nulla. Non risponde a un dubbio specifico, non riduce incertezza, non aiuta la conversione e non migliora la comprensione della pagina.
Esempio di FAQ forte:
Domanda: Quanto tempo serve per migrare un sito WordPress da HTTP a HTTPS senza perdere traffico organico?
Risposta: Per un sito piccolo la migrazione può richiedere poche ore operative, ma il monitoraggio SEO dovrebbe continuare per almeno 2-4 settimane. Vanno controllati redirect 301, canonical, sitemap, Search Console, mixed content, link interni e variazioni di indicizzazione.
Qui la risposta è concreta. Aiuta l’utente, anticipa obiezioni, dimostra competenza e arricchisce semanticamente la pagina.
La rimozione della feature non colpisce tutti allo stesso modo. Il valore residuo delle FAQ dipende dal tipo di sito e dal ruolo che quelle domande hanno nel percorso dell’utente.
Negli e-commerce le FAQ non servono solo alla SEO. Servono a ridurre attrito prima dell’acquisto.
Domande su spedizione, resi, compatibilità, materiali, taglie, garanzia, disponibilità e tempi di consegna possono incidere direttamente sulla conversione.
Per questo motivo, anche senza rich result, le FAQ possono restare importanti nelle schede prodotto, nelle categorie strategiche e nelle pagine informative collegate al funnel.
Nei contenuti editoriali le FAQ devono evitare l’effetto “appendice SEO”. Se il tema è già spiegato bene nell’articolo, una sezione FAQ può servire a sintetizzare punti chiave, chiarire dubbi ricorrenti o coprire sotto-intenti non trattati nel corpo principale.
Se invece la FAQ ripete frasi già presenti nel testo, diventa rumore.
Per attività locali, professionisti e servizi territoriali, le FAQ possono essere ancora molto utili. Orari, zone servite, modalità di prenotazione, documenti richiesti, tempi di intervento e costi indicativi sono informazioni ad alto valore pratico.
Anche senza espansione in SERP, queste risposte migliorano la qualità della landing page e possono ridurre chiamate inutili o richieste non qualificate.
Nel B2B le FAQ possono aiutare a spiegare processi lunghi, criteri di accesso, modelli di pricing, tempistiche, deliverable e responsabilità del cliente.
Qui il valore non è il rich result. Il valore è commerciale: ridurre incertezza e portare l’utente più vicino alla richiesta di contatto.
La rimozione delle FAQ non riduce l’importanza complessiva dei dati strutturati. Riduce l’importanza di una specifica aspettativa: implementare schema per ottenere automaticamente una decorazione in SERP.
I dati strutturati restano utili quando aiutano i motori a comprendere meglio entità, relazioni e proprietà di una pagina.
Per molti siti, le priorità possono spostarsi su altri markup più coerenti con il business:
La regola è sempre la stessa: prima viene il contenuto reale, poi il dato strutturato che lo descrive. Non il contrario.
La rimozione dei FAQ rich results arriva in una fase in cui la SEO sta cambiando anche per effetto di AI Overviews, motori generativi, chatbot di ricerca e sistemi di risposta sintetica.
Questo porta a una domanda inevitabile: se Google non mostra più i FAQ rich results, ha ancora senso strutturare contenuti in formato domanda-risposta?
Sì, ma con una precisazione: non perché il formato FAQ garantisca visibilità nei sistemi AI. Nessun markup garantisce citazioni, sintesi o inclusioni automatiche in AI Overviews, ChatGPT, Gemini, Perplexity o Copilot.
Ha senso perché il formato domanda-risposta può essere molto leggibile per utenti e macchine quando risponde a intenti reali.
I sistemi generativi lavorano su segnali multipli: contenuto testuale, contesto, entità, autorevolezza, freschezza, citazioni, coerenza, struttura della pagina, fonti esterne e qualità complessiva del documento.
Le FAQ possono aiutare solo se fanno parte di un contenuto solido. Non sono una scorciatoia per entrare nell’AI Search. Sono un formato utile quando chiariscono informazioni che l’utente potrebbe cercare in forma conversazionale.
La storia dei FAQ rich results mostra un problema ricorrente nella SEO: la tendenza a trasformare ogni opportunità di visibilità in una formula replicabile.
Quando Google introduce una feature, il mercato reagisce spesso nello stesso modo:
Questo ciclo si è visto più volte. Non riguarda solo le FAQ. Riguarda review snippet, HowTo, video, immagini, markup abusati, elementi di SERP e qualunque formato possa essere manipolato per ottenere visibilità aggiuntiva.
La lezione è semplice: una strategia SEO non dovrebbe dipendere da feature che Google può spegnere dall’oggi al domani.
Le feature sono opportunità tattiche. I contenuti, l’architettura, la reputazione e la capacità di rispondere meglio degli altri all’intento di ricerca sono asset strategici.
Chi gestisce siti con dati strutturati FAQ dovrebbe fare un audit leggero ma ordinato. Non serve cancellare tutto, ma serve sapere cosa è presente, dove, perché e con quale qualità.
Il primo passo è mappare le URL che contengono markup FAQPage. Si può fare con un crawler SEO, con una scansione del codice sorgente, con esportazioni dal CMS o con script personalizzati.
Per ogni URL conviene registrare:
Le domande e le risposte dichiarate nel dato strutturato devono essere presenti anche nel contenuto visibile. Se il markup contiene testo non mostrato all’utente, contenuti vecchi o risposte diverse da quelle pubblicate, va aggiornato.
Non tutte le FAQ meritano lo stesso trattamento. Le FAQ strategiche rispondono a dubbi reali e possono influenzare comprensione, fiducia e conversione. Le FAQ decorative servivano solo a ottenere il rich result.
Le prime vanno migliorate. Le seconde vanno eliminate o integrate meglio nel contenuto principale.
Prima della scomparsa completa dei report, conviene esportare i dati storici legati ai FAQ rich results da Search Console.
Questo permette di conservare uno storico utile per analisi future, soprattutto se il sito ha beneficiato della feature negli anni precedenti.
Chi usa Looker Studio, API, script o report ricorrenti deve rimuovere filtri e dipendenze legati alla search appearance FAQ.
Meglio intervenire prima che il dato sparisca, invece di ritrovarsi con report vuoti o errori nelle automazioni.
Se nel processo editoriale era prevista l’aggiunta automatica di una sezione FAQ a ogni articolo, è il momento di cambiare approccio.
Le FAQ non devono essere un obbligo di template. Devono essere una scelta editoriale.
Una buona sezione FAQ dovrebbe nascere da domande concrete. Non da keyword inserite in forma interrogativa.
Per riscrivere una FAQ in modo utile, conviene partire da quattro fonti:
Una FAQ efficace ha alcune caratteristiche riconoscibili:
Il formato migliore non è sempre domanda-risposta. A volte una tabella, una checklist, un confronto o un blocco “cosa sapere prima di acquistare” funzionano meglio.
La fine del rich result FAQ può quindi essere un’occasione positiva: meno automatismi SEO, più progettazione del contenuto.
Dal punto di vista tecnico, il lavoro consigliato è questo:
FAQPage;Una buona implementazione JSON-LD non deve essere lasciata al caso. Anche se non genera più un rich result, resta parte del codice della pagina e deve essere mantenuta pulita.
Per consulenti e agenzie, questa notizia va comunicata con precisione. Dire “Google ha eliminato le FAQ” è sbagliato. Dire “non servono più le FAQ” è ancora più sbagliato.
Una spiegazione corretta potrebbe essere:
Google ha rimosso la visualizzazione espansa delle FAQ nei risultati di ricerca. Questo non penalizza il sito e non obbliga a cancellare le FAQ. Dobbiamo però aggiornare il modo in cui valutiamo questo markup: non è più una leva per ottenere spazio aggiuntivo in SERP, ma può restare utile se migliora chiarezza, esperienza utente e comprensione semantica della pagina.
Questo tipo di comunicazione evita allarmismi e sposta la discussione sul punto giusto: la qualità del contenuto, non la nostalgia per una feature di Google.
La fase successiva a ogni aggiornamento Google produce sempre interpretazioni estreme. Anche in questo caso ci sono alcuni errori da evitare.
Le FAQ non sono diventate inutili. È diventata inutile l’aspettativa di ottenere un rich result visibile in Google Search.
È vero che un markup non utilizzato non è automaticamente un problema. Ma contenuti inutili, duplicati o scritti male peggiorano comunque la qualità percepita della pagina.
Le FAQ possono aiutare conversioni, supporto clienti, chiarezza informativa e comprensione del servizio. Il CTR organico non è l’unica metrica.
I dati strutturati aiutano a descrivere contenuti, ma non trasformano automaticamente una pagina mediocre in una pagina competitiva.
La parte più concreta del lavoro potrebbe essere proprio nei report. Se un sistema continua a cercare una search appearance che non esiste più, il problema diventa tecnico e operativo.
La rimozione dei FAQ rich results si inserisce in una trasformazione più grande della ricerca.
Google sta progressivamente riducendo alcune feature facilmente attivabili dai siti e aumentando il peso di elementi controllati direttamente dal motore: AI Overviews, knowledge panel, moduli verticali, risultati arricchiti selettivi, contenuti generati o sintetizzati, risposte immediate e layout dinamici.
Questo non significa che la SEO tecnica perda valore. Significa che deve smettere di essere vista come un insieme di trucchi per accendere badge in SERP.
La SEO tecnica utile oggi è quella che rende un sito:
In questo contesto, i dati strutturati non scompaiono. Cambia il modo in cui vanno valutati.
Per gestire bene questo cambiamento, la priorità non è intervenire in modo impulsivo. La priorità è ordinare il lavoro.
Un piano pratico può essere questo:
Il lavoro migliore non sarà quello di chi cancella più markup. Sarà quello di chi distingue tra codice inutile, contenuto utile e dati davvero necessari per interpretare correttamente una pagina.
No. Google ha eliminato i FAQ rich results nella Ricerca. Le FAQ possono restare nella pagina e il tipo di dato strutturato FAQPage continua a esistere come vocabolario Schema.org.
Sì, il markup può essere ancora valido se descrive correttamente contenuti visibili nella pagina. Il fatto che Google non mostri più il rich result non rende automaticamente errato il markup.
Possono aiutare se migliorano il contenuto, chiariscono dubbi reali, coprono sotto-intenti utili e rendono la pagina più completa. Non aiutano più come scorciatoia per ottenere spazio aggiuntivo in SERP.
No. Conviene rimuovere solo le FAQ artificiali, ripetitive o create esclusivamente per intercettare il rich result. Le FAQ utili agli utenti possono restare.
I report e le search appearance dedicate ai FAQ rich results verranno rimossi. Anche il supporto nella Search Console API sarà dismesso, quindi dashboard e automazioni devono essere aggiornate.
Può influire sul CTR solo nei casi in cui il sito riceveva ancora visibilità tramite FAQ rich results. Per molti siti l’impatto sarà limitato, perché Google aveva già ridotto questa feature dal 2023.
Non c’è una garanzia diretta. Tuttavia, contenuti chiari, ben strutturati e coerenti possono essere più facili da comprendere per sistemi automatici. Il formato FAQ va usato quando migliora davvero la qualità informativa.
Per anni abbiamo spiegato il canonical come un segnale. Non una direttiva assoluta. Non un redirect. Non un blocco. Un’indicazione.
Con rel="canonical" dici a Google, Bing e agli altri sistemi automatici: “tra queste URL simili o duplicate, considera questa come versione preferita”. Poi il motore decide se rispettarla, ignorarla o sostituirla con la propria scelta algoritmica.
Cloudflare, con Redirects for AI Training, sposta il problema su un altro piano: per i crawler AI verificati destinati al training, il canonical può diventare un redirect HTTP 301 effettivo.
Non per gli utenti. Non per Googlebot. Non per gli AI assistant che recuperano pagine su richiesta dell’utente.
Solo per una classe specifica di bot AI: quelli classificati da Cloudflare come AI Crawler, cioè crawler che raccolgono contenuti per l’addestramento dei modelli.
Questa è la novità vera. Il canonical non serve più solo a consolidare segnali SEO: diventa una regola di distribuzione del contenuto verso i sistemi di training AI. E questo, per chi lavora su SEO tecnica, crawling, documentazione, editoria, e-commerce e GEO, non è un dettaglio. È un cambio di postura.
Il 17 aprile 2026 Cloudflare ha annunciato Redirects for AI Training, una funzione di AI Crawl Control che trasforma i canonical tag già presenti nelle pagine HTML in redirect 301 Moved Permanently per crawler AI verificati.
Il comportamento è questo:
<link rel="canonical" href="https://www.example.com/pagina-canonica/" />Se un crawler AI verificato richiede una pagina non canonica, e quella pagina dichiara una canonical diversa ma sullo stesso origin, Cloudflare può rispondere con:
HTTP/1.1 301 Moved Permanently
Location: https://www.example.com/pagina-canonica/
Cloudflare documenta che la funzione si attiva da AI Crawl Control > Quick Actions ed è disponibile sui piani Pro, Business ed Enterprise senza costo aggiuntivo. Può essere attivata anche via API o tramite Configuration Rules per limitarla a specifici host, sottodomini o path.
Il punto importante è che il sito non deve per forza cambiare la propria architettura lato origin: Cloudflare legge la risposta HTML, estrae il canonical dal <head> e, se le condizioni sono rispettate, applica il redirect all’edge.
Il problema è semplice: molti segnali SEO sono segnali “educati”.
Funzionano bene quando l’interlocutore è un motore di ricerca che ha interesse a mantenere un indice pulito. Ma i crawler AI non sempre hanno lo stesso obiettivo, la stessa frequenza di aggiornamento o lo stesso rispetto dei segnali storicamente usati nella SEO.
Cloudflare porta un caso molto concreto: nella propria documentazione aveva vecchie versioni di Wrangler ancora accessibili, con banner di deprecazione, meta noindex e canonical verso le pagine aggiornate. Tutti i segnali dicevano: “questo contenuto è vecchio, usa la versione nuova”. Eppure Cloudflare dichiara che, su developers.cloudflare.com, i bot nella categoria AI Crawler hanno generato 4,8 milioni di visite negli ultimi 30 giorni e hanno consumato contenuti deprecati allo stesso ritmo dei contenuti aggiornati.
Questo è il punto SEO/GEO più interessante: se un crawler AI ingerisce documentazione obsoleta, il problema non è solo che spreca crawl budget. Il problema è che quella versione può entrare nei dati usati per addestramento o aggiornamento del modello.
Quindi, domani, un assistente AI potrebbe spiegare il tuo prodotto, la tua API, il tuo listino o la tua policy usando una pagina vecchia.
Non perché la pagina nuova non esista.
Ma perché il crawler ha visto anche quella sbagliata.
Nel modello SEO classico, il canonical è una relazione dichiarativa.
Secondo RFC 6596, la relazione canonical specifica la versione preferita di una risorsa quando esistono contenuti duplicati o sovrapposti; le applicazioni, come i motori di ricerca, possono concentrare l’elaborazione sulla risorsa canonica e consolidare proprietà come segnali e riferimenti.
Google supporta rel="canonical" nell’HTML o via header HTTP, ma continua a trattarlo come parte di un sistema di canonicalizzazione, non come un redirect automatico universale. Google raccomanda inoltre di usare URL assolute e di posizionare il canonical nel <head> valido della pagina.
Cloudflare aggiunge una cosa diversa:
| Scenario | Utente umano | Googlebot / crawler search | AI Assistant / AI Search bot | AI Crawler training |
|---|---|---|---|---|
| Pagina con canonical self-referencing | vede la pagina | vede la pagina | vede la pagina | vede la pagina |
| Pagina con canonical verso URL same-origin diversa | vede la pagina | vede la pagina | vede la pagina | riceve 301 verso canonical |
| Pagina con canonical cross-origin | vede la pagina | vede la pagina | vede la pagina | vede la pagina, perché Cloudflare ignora canonical cross-origin |
| Pagina non HTML | vede la risorsa | vede la risorsa | vede la risorsa | nessun redirect automatico |
Questo significa che il canonical resta un segnale per la SEO tradizionale, ma diventa un enforcement selettivo per i crawler AI di training.
È qui che entra la GEO.
La GEO, o Generative Engine Optimization, non è solo “farsi citare da ChatGPT”.
È anche controllare quali versioni del tuo contenuto sono più facilmente recuperabili, leggibili, riutilizzabili e ingeribili dai sistemi AI.
Nella SEO tradizionale ci siamo abituati a ragionare così:
URL duplicate → canonical → consolidamento ranking/indexingNella GEO il flusso diventa:
URL duplicate o obsolete → canonical enforced → riduzione del rischio che i modelli apprendano contenuti sbagliatiAttenzione: questo non significa che attivando Redirects for AI Training “correggi” immediatamente le risposte dei modelli.
Cloudflare stessa parla di aspettativa e ipotesi: reindirizzare i crawler verso contenuti aggiornati dovrebbe migliorare nel tempo le risposte AI su strumenti legacy, ma l’effetto dipende da pipeline di training chiuse, tempi di recrawl e aggiornamento dei modelli. Quello che migliora subito è il contenuto servito al crawler nel momento dell’accesso.
Questo è il modo corretto di leggerla.
Non è una bacchetta magica GEO.
È un controllo tecnico sul dato che esce dal tuo sito.
Cloudflare usa due input principali:
<link rel="canonical"> presente nella risposta HTML.Il flusso è:
1. Arriva una richiesta da un bot verificato.
2. Cloudflare verifica se il bot è nella categoria AI Crawler.
3. Cloudflare richiede la pagina all’origin.
4. Legge lo stream HTML, in particolare il <head>.
5. Cerca <link rel="canonical" href="...">.
6. Risolve eventuali URL relative.
7. Verifica che la canonical sia same-origin e diversa dall’URL richiesta.
8. Se tutto torna, restituisce 301 verso la canonical.
La documentazione Cloudflare specifica che, se non trova un canonical, se il canonical è self-referencing, se è cross-origin o se non è valido per la regola, la risposta passa invariata.
Questo è fondamentale: Cloudflare non “sceglie” la canonical al posto tuo. Esegue quello che hai già dichiarato.
Se la tua canonicalizzazione è sporca, la stai rendendo più pericolosa.
Cloudflare distingue tra categorie diverse di bot AI.
Esempi:
Redirects for AI Training riguarda solo i bot verificati nella categoria AI Crawler. Non coinvolge AI Assistant e AI Search bot. Cloudflare lo dichiara esplicitamente nella documentazione della funzione e nella documentazione sulle categorie di bot.
Questa distinzione è strategica.
Perché non tutti i bot AI hanno lo stesso valore.
Bloccare o reindirizzare un training crawler può avere senso se vuoi evitare che pagine obsolete finiscano nei dataset. Bloccare un bot di AI Search o un assistant user-triggered, invece, può ridurre la possibilità di essere letto, citato o recuperato in un contesto conversazionale.
La GEO seria parte da qui: non trattare “i bot AI” come una massa indistinta.
Scenario tipico:
/docs/v1/installazione/
canonical → /docs/current/installazione/
La vecchia documentazione deve restare online perché alcuni utenti usano ancora vecchie versioni del prodotto. Per Google puoi decidere di mantenerla noindex o canonicalizzata. Per gli utenti umani resta utile.
Ma per un crawler AI di training è rumore.
Se il modello ingerisce la guida vecchia, domani potrebbe suggerire comandi non più validi, endpoint deprecati o parametri rimossi.
Qui Redirects for AI Training ha molto senso.
Non cancelli la vecchia pagina.
Non rompi l’esperienza dell’utente legacy.
Non cambi il comportamento di Googlebot.
Ma dici ai training crawler: “questa è la versione che devi vedere”.
È probabilmente il caso d’uso migliore.
Molte aziende hanno centinaia di articoli help center:
/help/vecchia-dashboard-creazione-report/
canonical → /help/report-dashboard/
L’articolo vecchio resta accessibile perché linkato da ticket storici, forum, email o onboarding passati. Ma non vuoi che un modello AI lo tratti come documento valido.
Con il redirect selettivo puoi mantenere la pagina per gli umani e forzare i training crawler verso l’articolo aggiornato.
Qui il valore non è solo SEO. È customer care.
Un assistente AI che consiglia procedure vecchie aumenta ticket, frizione e sfiducia.
Caso classico:
/prodotto/scarpa-x?color=nero&size=42
canonical → /prodotto/scarpa-x/
Per Google il canonical serve a consolidare varianti, parametri e duplicazioni.
Per i crawler AI di training il problema è diverso: se ogni variante viene ingerita come contenuto separato, il modello può sovrappesare informazioni ridondanti o confuse.
Qui l’uso è interessante ma va gestito con cautela.
Se la pagina canonica contiene tutte le informazioni realmente utili, bene.
Se invece le varianti hanno informazioni importanti — materiali, disponibilità, compatibilità, prezzi, condizioni — il canonical potrebbe impoverire ciò che il crawler AI vede.
La domanda non è: “questa pagina è duplicata per Google?”.
La domanda diventa: “questa pagina non canonica contiene informazioni che vorrei far apprendere a un sistema AI?”.
Non sempre la risposta coincide.
Esempio:
/scarpe-running?brand=nike&prezzo=100-150
canonical → /scarpe-running/
In SEO classica possiamo canonicalizzare filtri non strategici per evitare duplicazioni e spreco di crawl.
Ma in GEO, una pagina filtrata può contenere un’intenzione commerciale precisa:
migliori scarpe running nike sotto 150 euroSe mandi sempre tutto alla categoria generica, potresti perdere granularità semantica utile.
Quindi: non attivare questa logica a occhi chiusi su tutto l’e-commerce.
Prima devi distinguere:
Redirects for AI Training amplifica la tua architettura informativa. Se l’architettura è sbagliata, amplifica anche l’errore.
Scenario:
/news/bonus-2024-requisiti/
canonical → /guide/bonus-requisiti-aggiornati/
Un editore può avere vecchi articoli ancora raggiungibili, ma una guida evergreen aggiornata che rappresenta la versione attuale.
Per un utente umano ha senso leggere anche la cronologia.
Per un crawler AI di training, invece, il contenuto vecchio può diventare tossico.
Qui la funzione è utile se hai una politica editoriale chiara:
vecchio articolo informativo → canonical verso guida aggiornataMa attenzione: non usare canonical per cancellare la storia.
Se un articolo parla di “cosa è successo nel 2024”, non è duplicato della guida 2026. È un documento storico. Canonicalizzarlo verso una pagina aggiornata può essere sbagliato sia per SEO sia per AI.
Il canonical non serve a dire “questa pagina non mi piace più”.
Serve a dire “questa pagina è una variante duplicata o sostanzialmente sovrapposta di un’altra”.
Esempio:
/prodotto/software-basic-2022/
canonical → /prodotto/software-basic/
Se la vecchia versione del prodotto non è più venduta, ma la pagina resta online per supporto o documentazione, puoi voler mandare i training crawler alla pagina corrente.
Per SaaS, fintech, legaltech, software B2B e marketplace è un caso molto rilevante.
Perché un modello AI che apprende il vecchio listino, le vecchie feature o le vecchie limitazioni può generare risposte commercialmente dannose.
Qui il consiglio pratico è: creare una mappa tra pagine obsolete e pagine correnti, poi verificare che il canonical rifletta davvero quella mappa.
La tentazione sarà: “attivo la funzione, tanto usa i canonical già esistenti”. Errore.
Prima devi auditare i canonical. Checklist minima:
- canonical self-referencing sulle pagine principali;
- canonical coerenti sulle pagine duplicate;
- niente canonical verso URL 404, 3xx o noindex non voluti;
- niente catene canonical;
- niente canonical incoerenti tra HTML e header HTTP;
- canonical nel <head> valido;
- canonical assolute dove possibile;
- canonical same-origin se vuoi che Cloudflare applichi il redirect;
- canonical entro i primi 256 KB dell’HTML non compresso.
Il limite dei 256 KB è specifico della funzione Cloudflare: il tag deve comparire nei primi 256 KB della risposta HTML non compressa. Se il tuo <head> è enorme, generato male o pieno di script, puoi perdere l’effetto.
Non partirei dall’intero dominio.
Partirei da:
/docs/
/help/
/support/
/kb/
/guide/
/prodotti-obsoleti/
/archivio/
Oppure da sottodomini:
docs.example.com
support.example.com
developer.example.com
Cloudflare consente di attivare la funzione anche su subdomain o path specifici tramite Configuration Rules, ad esempio con espressioni come:
http.host eq "docs.example.com"oppure:
starts_with(http.request.uri.path, "/docs/")Questo è l’approccio corretto: prima le aree dove l’obsolescenza è un rischio reale, poi eventualmente il resto.
Cloudflare registra il target canonical nel campo:
redirects_for_ai_training_targetPuoi interrogarlo via GraphQL Analytics API o Logpush.
Metriche utili:
- quante richieste AI Crawler ricevono 301;
- quali URL non canoniche vengono più richieste;
- quali canonical target ricevono più traffico AI;
- quali sezioni obsolete sono ancora molto crawlate;
- quali crawler vengono reindirizzati più spesso;
- quali pagine non vengono reindirizzate perché self-canonical;
- eventuali loop o pattern anomali.
Per la GEO, questa è una nuova forma di osservabilità. Non misuri solo il traffico organico.
Misuri quale versione del tuo sito viene esposta ai crawler AI.
robots.txt dice dove un crawler può o non può andare.
Redirects for AI Training dice: “se vieni qui e sei un training crawler verificato, ti mando alla versione canonica”.
Sono due livelli diversi.
Cloudflare ha anche introdotto strumenti legati ai Content Signals, che permettono di dichiarare preferenze come search, ai-input e ai-train dentro robots.txt; ad esempio, un sito può esprimere search=yes, ai-train=no. Ma questi segnali sono una dichiarazione di preferenza/diritti, non la stessa cosa di un redirect tecnico verso una URL canonica.
La strategia matura non è scegliere uno o l’altro.
È combinare:
robots.txt / Content Signals → policy di accesso e uso
canonical → gerarchia dei contenuti
Redirects for AI Training → enforcement verso crawler AI verificati
log analysis → verifica operativaSe una pagina ha valore autonomo, non deve puntare a una canonical generica solo perché è vecchia, scomoda o poco performante.
Il canonical non è un cestino.
È una relazione tra contenuti duplicati, quasi duplicati o in rapporto di versione preferita.
RFC 6596 consente canonical su domini diversi, e Google può supportare scenari cross-domain. Ma Cloudflare Redirects for AI Training, per questa funzione, applica il redirect solo quando la canonical è same-origin. Le canonical cross-origin vengono ignorate dalla funzione.
Quindi:
<link rel="canonical" href="https://nuovodominio.com/pagina/" />potrebbe avere senso per Google, ma non aspettarti che questa funzione Cloudflare produca il 301 per i training crawler.
No. Vale per bot verificati nella categoria AI Crawler. Non vale per AI Assistant e AI Search bot. Non è una soluzione per scraper non verificati, user-agent spoofati o traffico malevolo non classificato.
Per quello servono altre regole: WAF, Bot Management, allow/block selettivi, rate limiting, log analysis.
Molti CMS generano canonical automaticamente.
A volte bene.
A volte male.
A volte in modo diverso tra template, plugin, parametri, lingua, paginazione, filtri e pagine AMP.
Prima di usare una funzione che trasforma canonical in redirect per una classe di crawler, devi sapere chi genera quel tag.
Non è un dettaglio frontend.
È governance del contenuto.
Crea una tabella:
| Sezione | Rischio AI | Tipo contenuto | Strategia |
|---|---|---|---|
/docs/v1/ |
Alto | documentazione deprecata | redirect AI verso docs attuali |
/help/old/ |
Alto | supporto obsoleto | canonical verso articoli aggiornati |
/blog/archivio/ |
Medio | contenuto storico | valutare caso per caso |
/product/?filter= |
Medio | faceted navigation | distinguere filtri utili/inutili |
/news/ |
Variabile | news temporali | non canonicalizzare storia reale |
Usa crawler SEO, log e query mirate.
Esempi di controlli:
URL richiesta → canonical dichiarata → status canonical → indexability → same-origin → template → sezioneDevi trovare:
- canonical mancanti;
- canonical multiple;
- canonical fuori dal <head>;
- canonical verso 404;
- canonical verso redirect;
- canonical incoerenti tra desktop/mobile;
- canonical verso URL parametrizzate;
- canonical cross-origin;
- canonical troppo tardi nel codice.Non attivarla subito ovunque.
Meglio una regola:
starts_with(http.request.uri.path, "/docs/")Oppure:
http.host eq "support.example.com"Così puoi misurare prima gli effetti su una porzione controllata.
Dopo l’attivazione guarda:
redirects_for_ai_training_target
cf.verified_bot_category
user agent
path richiesto
status code
host
content-type
Domande utili:
- quali vecchie URL ricevono più richieste?
- quali crawler stanno consumando contenuti obsoleti?
- quali canonical target sono più importanti per i modelli?
- ci sono sezioni che pensavamo morte ma vengono ancora crawlate?
- i redirect stanno andando verso pagine davvero corrette?La parte tecnica serve a scoprire un problema editoriale.
Se un training crawler continua a richiedere documenti obsoleti, forse hai:
- link interni vecchi;
- sitemap sporche;
- documentazione legacy troppo esposta;
- canonical deboli;
- redirect mancanti;
- pagine archiviate senza contesto;
- duplicati generati dal CMS.
Redirects for AI Training non sostituisce la pulizia del sito. La rende più urgente.
Per come è documentata, la funzione non cambia il comportamento verso:
- utenti umani;
- browser;
- Googlebot;
- Bingbot;
- crawler search tradizionali;
- AI Assistant;
- AI Search bot.
Cloudflare dichiara esplicitamente che browser, motori di ricerca e AI Assistants ricevono la pagina originale invariata.
Quindi non va presentata come “nuovo fattore ranking”. Non lo è.
Cambia quale contenuto ricevono i crawler AI di training quando arrivano su una pagina non canonica.
Questo ha tre impatti:
Il terzo punto è il più importante.
Fino a ieri il canonical parlava soprattutto ai motori di ricerca.
Ora può parlare anche ai sistemi che alimentano, aggiornano o preparano i modelli AI.
Questa è una delle prime funzioni GEO davvero tecniche. Non perché “ottimizza per ChatGPT” nel senso banale del termine.
Ma perché agisce sul livello più ignorato della GEO: la qualità del contenuto che i sistemi automatici possono acquisire.
Molti parlano di GEO come se bastasse scrivere FAQ, usare schema markup e mettere frasi più citabili.
Va bene, ma è superficie. La parte più interessante è un’altra:
quale versione del contenuto può vedere un crawler AI?
quale contenuto vecchio sto ancora esponendo?
quali duplicati sto lasciando ingerire?
quali pagine non voglio bloccare agli utenti ma non voglio far apprendere ai modelli?
Cloudflare Redirects for AI Training non risolve tutta la questione AI crawler. Non blocca gli scraper non verificati. Non ti garantisce citazioni. Non corregge i modelli già addestrati. Non sostituisce una strategia legale sui diritti dei contenuti.
Però introduce un principio importante:
la canonicalizzazione non è più solo un problema di indice. È un problema di dataset.
E quando il contenuto diventa dataset, la SEO tecnica diventa infrastruttura di controllo.
La attiverei subito, dopo audit, su siti con:
- documentazione tecnica versionata;
- API docs;
- knowledge base;
- help center;
- pagine prodotto obsolete;
- cataloghi con molte URL parametriche;
- portali editoriali con guide evergreen e articoli superati;
- SaaS con vecchie feature documentate;
- siti legal/finance/medical con contenuti aggiornati nel tempo.Aspetterei se:
- i canonical sono generati male dal CMS;
- ci sono molte canonical cross-domain;
- le pagine non canoniche contengono informazioni importanti;
- il sito usa faceted navigation senza una strategia chiara;
- il team non ha accesso ai log;
- non è chiaro quali bot AI vadano bloccati, permessi o reindirizzati.
Attivarla senza audit è come fare un redirect massivo senza mappa. Magari va bene. Ma se va male, te ne accorgi tardi.
Redirects for AI Training è una funzione piccola solo in apparenza.
Prende un tag che la SEO usa da anni e lo sposta nel mondo AI:
<link rel="canonical">Prima era un consiglio. Ora, per una categoria precisa di crawler, può diventare una regola HTTP.
La direzione è chiara: la SEO tecnica non sta morendo con l’AI. Sta diventando più infrastrutturale. Meno “come scrivo il titolo per posizionarmi”.
Più “quale versione della conoscenza sto rendendo disponibile ai sistemi automatici”.
E questa, per chi fa GEO sul serio, è una differenza enorme.
C’è una cosa che, secondo me, va messa sul tavolo senza girarci intorno: nel 2026 non stiamo più facendo SEO per un motore che si limita a ordinare documenti. Stiamo facendo SEO per un sistema che legge il contenuto, lo interpreta, lo riformula e, quando gli conviene, ne riscrive anche la presentazione.
Ed è questo il punto che tanti stanno ancora leggendo male. Per anni il copywriting in SERP ha avuto un presupposto abbastanza semplice: tu scrivevi un title, impostavi un framing, decidevi come raccontare un contenuto e Google, nel bene o nel male, usava quella base. Poteva tagliare, accorciare, cambiare un H1, scegliere un anchor text più forte. Ma il gioco era ancora riconoscibile: tu scrivevi, Google adattava.
Adesso il livello si è alzato. O, se preferisci, si è complicato. Perché quando Google inizia a testare titoli generati con AI direttamente nei risultati classici di Search, il problema non è più soltanto il rewrite. Il problema è che il motore non si limita a selezionare una variante più comoda: inizia a produrre una propria versione del tuo contenuto per farla funzionare meglio dentro la sua interfaccia. E qui il tema non è estetico. È strategico. Read More
Il 20 marzo 2026 Google ha aggiornato la documentazione sul crawling introducendo Google-Agent, un nuovo user agent destinato agli agenti ospitati sull’infrastruttura Google che navigano il web ed eseguono azioni su richiesta dell’utente. Non è un dettaglio da addetti ai lavori fissati con i changelog. È uno di quei segnali che, se letti bene, spiegano dove sta andando il web e perché chi fa SEO tecnica oggi non può più limitarsi a ragionare solo in termini di Googlebot. Read More
L’ecosistema dell’Information Retrieval e dell’ottimizzazione per i motori di ricerca sta attraversando una metamorfosi strutturale e paradigmatica di proporzioni storiche, segnando il definitivo tramonto dell’era basata sulla semplice indicizzazione e restituzione di collegamenti ipertestuali. La transizione da un modello di utilità basato sui tradizionali “dieci link blu” a un ecosistema di sintesi generativa e agentica ha raggiunto un punto di svolta critico. Questo cambiamento epocale è culminato nella concessione, all’inizio dell’anno 2026, di una tecnologia proprietaria che promette di ridefinire radicalmente il concetto stesso di navigazione web, disintermediando in modo aggressivo il rapporto tra creatori di contenuti, marchi commerciali e consumatori finali.
La presente analisi tecnica disseziona le fondamenta ingegneristiche, algoritmiche e strategiche di questa evoluzione, concentrandosi sulle specifiche dell’architettura generativa, sui meccanismi di valutazione automatizzata della qualità e sulle profonde conseguenze per il digital marketing, la gestione della presenza online e l’economia dell’editoria digitale. Il documento esplora l’integrazione di queste nuove tecnologie con i costrutti storici della profilazione utente, delineando un quadro in cui l’ottimizzazione per i motori di ricerca cessa di essere una disciplina di formattazione semantica per divenire una complessa ingegneria dell’esperienza totale. Read More
Per anni abbiamo ottimizzato i siti web affinché Google potesse leggerli. Abbiamo usato Schema.org per trasformare stringhe di testo in entità comprensibili. Ma cosa succede quando il motore di ricerca smette di essere solo un lettore e diventa un attore? Read More
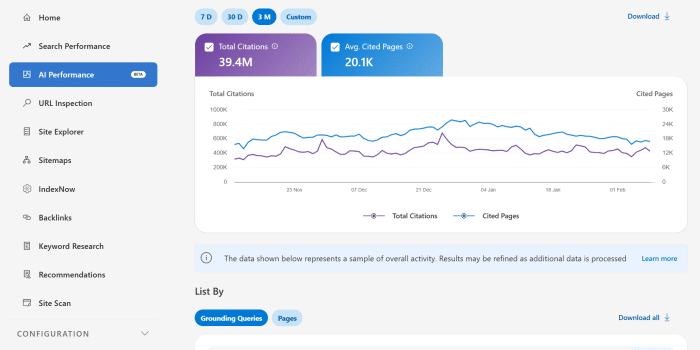
Microsoft ha annunciato una nuova funzionalità rivoluzionaria in Bing Webmaster Tools (BWT) chiamata “AI Performance” (in anteprima pubblica). Questo strumento nasce per rispondere a una delle domande più critiche della SEO moderna: come viene utilizzato il mio contenuto dai sistemi di Intelligenza Artificiale generativa? Read More
Ti sei mai domandato chi è il SEO? Quando guadagna e qual è il percorso formativo da fare? Scoprilo in questo articolo. Read More